 Dokument wagwoord herstel meester
Hoe om duplikate van 2T woordeboek te filter, oorgroot teks filter duplikate
Op die gebied van wagwoordkraak of dataverwerking is die besit van 'n 2T tekstipe woordeboeklêer' n baie kragtige hulpbron. So 'n groot lêer is egter dikwels geneig tot' n groot hoeveelheid duplikaatdata, wat nie net onnodige stoorspasie in beslag neem nie, maar ook die doeltreffendheid van daaropvolgende bedrywighede gebaseer op hierdie woordeboeklêer kan beïnvloed, soos die spoed van wagwoordsoektog. Daarom is die effektiewe filter van duplikaatinhoud' n baie kritieke stap.
1. Verstaan die bron en impak van duplikaatdata
Eerstens moet ons verstaan hoekom soveel duplikaatdata gegenereer Word. Tydens die konstruksie van' n woordeboeklêer kan data van verskeie databronne versamel Word, en daar is gedeeltelike oorvleueling tussen hierdie databronne. Byvoorbeeld, wanneer data van verskillende woordlyste, algemene wagwoordstelle, lyste van verskeie karakterkombinasies, ens. Versamel Word, kan sommige basiese woorde of eenvoudige wagwoordkombinasies in verskeie bronne bestaan.
Hierdie duplikaatdata sal baie nadelige gevolge hê. Vanuit 'n stoorperspektief is die spasie van 2T reeds baie groot As daar baie duplikaatinhoud is, is dit gelykstaande aan' n vermorsing van kosbare stoorplek. Wanneer u hierdie woordeboeklêer eintlik gebruik vir wagwoordkraak of ander bewerkings, kan duplikaatinhoud lei tot onnodige soek-en vergelykingsoperasies. Byvoorbeeld, as die algoritme tydens wagwoordkraak die inhoud in die woordeboek met die teikenwagwoord een vir een moet vergelyk, sal die duplikaatinhoud die aantal vergelykings verhoog en sodoende die hele kraakproses vertraag.
2. Filtermetode gebaseer op teksverwerkingsinstrumente
Gebruik gereedskap onder Windows-stelsel
-Gebruik PowerShell
-In Windows-stelsels bied PowerShell ryk teksverwerkingsvermoëns. Ons kan die volgende PowerShell-skrip gebruik om duplikaatlyne te verwyder:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-not contains $line) {
$uniqueLines + = $line
{
```
Hierdie skrif lees eers al die reëls in "dictionary.txt" na' n skikking "$lines" in. Gaan dan deur elke ry deur 'n lus. As' n ry nie in die nuwe skikking "$ uniqueLines" is nie, voeg dit by die nuwe skikking. Ten slotte, stoor die inhoud van die nuwe skikking in "unique_dictionary.txt".
Verdeel en verower algoritme
-Aangesien ons woordeboeklêers baie groot is (2T), kan direkte verwerking probleme ondervind soos onvoldoende geheue. Die verdeel-en-oorwin-algoritme kan hierdie probleem baie goed oplos. Ons kan hierdie groot lêer in verskeie kleiner sublêers verdeel. Byvoorbeeld, ons kan dit verdeel volgens' n sekere aantal reëls of lêergrootte.
-Herhaalde filtering Word dan afsonderlik vir elke sublêer uitgevoer. Hervoeg die verwerkte sublêers in een lêer. Tydens die samesmeltingsproses moet jy ook weer kyk vir duplikate, aangesien dieselfde inhoud tussen verskillende sublêers kan bestaan.
4. Verifieer die filterresultate
Nadat ons herhaalde filtering voltooi het, moet ons verifieer of die resultate korrek is. U kan' n paar eenvoudige metodes gebruik, soos om willekeurig lyne te kies en die aantal voorkomste van hierdie lyne in die oorspronklike lêer en die gefiltreerde lêer na te gaan. As dit verskeie kere in die oorspronklike lêer verskyn en slegs een keer in die gefiltreerde lêer verskyn, beteken dit dat die filter geldig is.
Daarbenewens kan die grootte van die oorspronklike lêer en die gefiltreerde lêer vergelyk Word. As die gefiltreerde lêergrootte aansienlik kleiner is as die oorspronklike lêer en normaal presteer in daaropvolgende toetse (soos om hierdie woordeboeklêer te gebruik om' n eenvoudige wagwoordsoektoets uit te voer om te sien of dit behoorlik werk en geen wagwoord wat moet bestaan, gemis Word nie), kan dit ook beteken dat herhaalde filterwerk goeie resultate behaal het.
Ons bediener gebruik 512G-geheue en 'n hoëspoed-NVMe-protokol-hardeskyfbediener. Dit het' n halwe maand geneem om die verwerking suksesvol te voltooi, en ons het' n stel doeltreffende verwerkingsskrifte verken webwerf kliëntediens vir kommunikasie Filter die slaggate wat tydens die herhalingsproses aangetref Word, en skryf outomatiese verwerkingsskrifte!
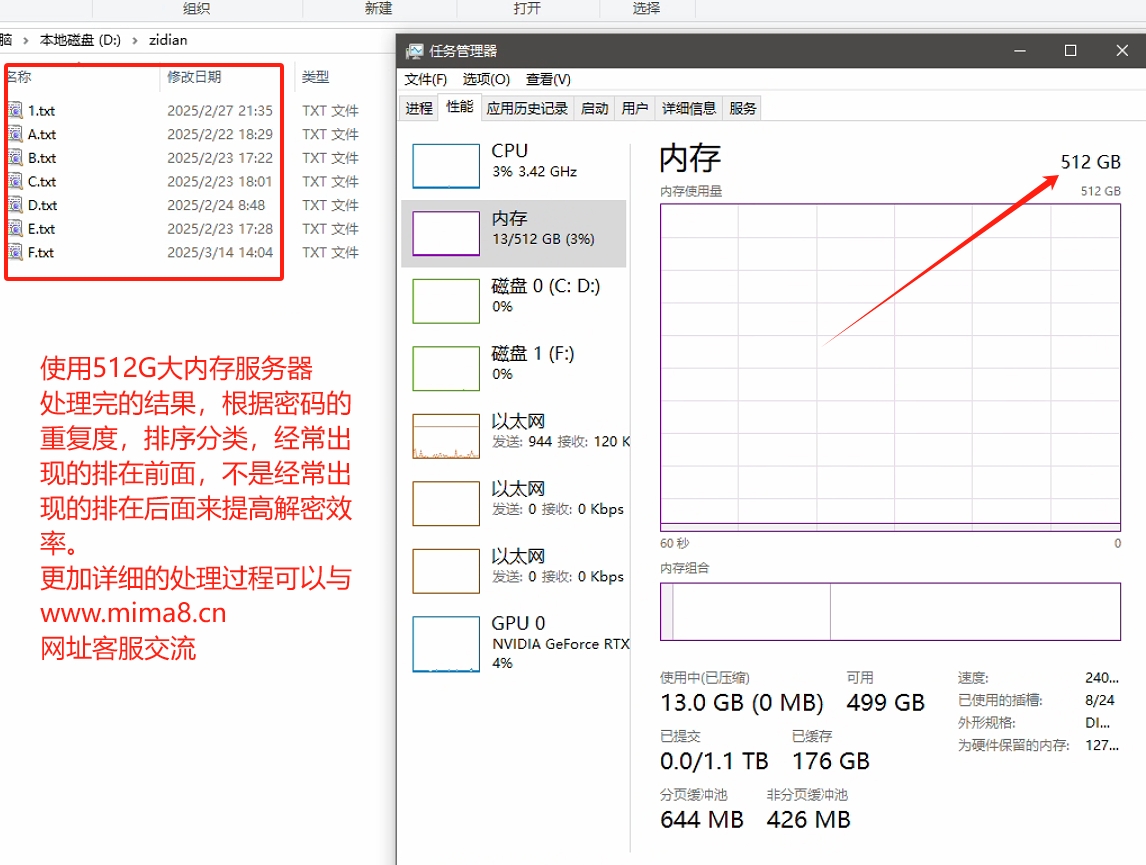
Die filter van duplikate in 2T se tekstipe woordeboeklêers is' n uitdagende maar baie noodsaaklike taak. Deur gereedskap en algoritmes redelik te kies, kan ons duplikaatinhoud effektief verwyder en die kwaliteit en gebruiksdoeltreffendheid van woordeboeklêers verbeter, wat van groot belang is in beide wagwoordkraak en ander toepassingscenario's gebaseer op hierdie woordeboeklêer.