 パスワードの回復
2T辞书から重复コンテンツをフィルタリングする方法、特大テキストの重复コンテンツをフィルタリングする方法
パスワード解読やデータ処理の分野では、2T のテキスト型辞書ファイルを持つことは非常に強力なリソースです。しかし、このような膨大なファイルには、多くの場合、大量の重複データが存在しやすく、不要なストレージスペースを占有するだけでなく、パスワード検索の速度など、この辞書ファイルに基づくその後の操作効率にも影響を与える可能性があります。したがって、その中の重複コンテンツを効果的にフィルタリングすることは非常に重要なステップです。
1. 重複データの出所と影響を理解する
まず、なぜこれほど多くの重複データが生成されるのかを理解する必要があります。辞書ファイルの構築プロセスでは、複数のデータソースからデータが収集され、これらのデータソース自体が部分的に重複している可能性があります。例えば、異なる単語リスト、共通の暗号セット、様々な文字の組み合わせのリストなどからデータを収集する場合、いくつかの基本的な単語または単純な暗号の組み合わせが複数のソースに存在し得る。
これらの重複データは多くの悪影響を及ぼします。ストレージの観点から見ると、2Tのスペースはすでに非常に広大であり、その中に重複するコンテンツが大量に含まれている場合、貴重なストレージスペースを無駄にしてしまうことになります。この辞書ファイルを実際に使用してパスワードの解読やその他の操作を行う場合、重複したコンテンツは不要な検索や比較操作につながります。例えば、パスワードの解読において、アルゴリズムが辞書の内容とターゲットのパスワードを1つずつ比較する必要がある場合、重複する内容は比較の回数を増やし、解読プロセス全体の速度を遅らせる。
2. テキスト処理ツールに基づくフィルタリング方法
Windows システムのツールを使用
- PowerShell を使用
- Windows システムでは、PowerShell は豊富なテキスト処理機能を提供します。次の PowerShell スクリプトを使用して重複行を削除できます。
```powershell
$lines = Get - Content "dictionary.txt"
$uniqueLines = @()
foreach ($line in $line) {
if ($uniqueLines - $lineが含まれていません) {
```
このスクリプトは、まず "dictionary.txt" のすべての行を "$lines" の配列に読み込みます。次に、各行をループで繰り返し、新しい配列 "$uniqueLines" にない行がある場合は、この新しい配列に追加します。最後に、新しい配列の内容を「unique_dictionary.txt」に保存します。
分割制覇アルゴリズム
- 辞書ファイルが非常に大きい (2T) ため、直接処理するとメモリ不足などの問題が発生する可能性があります。分治アルゴリズムはこの問題をうまく解決することができる。この大きなファイルをいくつかの小さなサブファイルに分割できます。たとえば、特定の行数やファイルサイズに応じて分割できます。
- 次に、各サブファイルを個別に繰り返しフィルタリングします。処理されたサブファイルを1つのファイルに再マージします。マージ中に、異なるサブファイル間で同じコンテンツが存在する可能性があるため、重複コンテンツがないかどうかを再度確認する必要があります。
4. フィルタリング結果の検証
繰り返しフィルタリングを完了した後、結果が正しいかどうかを検証する必要があります。いくつかの行をランダムに抽出し、元のファイルとフィルタリングされたファイルでこれらの行の出現回数を確認するなど、いくつかの簡単な方法を使用できます。元のファイルでは複数回表示され、フィルタリングされたファイルでは一度しか表示されない場合、フィルタリングは有効です。
また、元のファイルとフィルタリングされたファイルのサイズを比較することもできます。フィルタリングされたファイル サイズが元のファイルよりも大幅に小さく、その後のテスト (この辞書ファイルを使用して単純なパスワード検索テストを実行し、正常に動作し、存在するはずのパスワードが欠落していないかどうかを確認するなど) で正常に動作する場合は、繰り返しフィルタリング作業が良好な結果を達成したことを示すこともできます。
私たちのサーバーは512Gのメモリ、高速NVMeプロトコルハードディスクサーバーを使用して、半月の時間をかけて、成功に処理を完了して、しかも一連の効率的な処理スクリプトを模索して、タイプの需要があればウェブサイトのカスタマーサービスに連絡して交流して、フィルタリング繰り返しの過程で踏んだピット、そして自動処理スクリプトの作成!
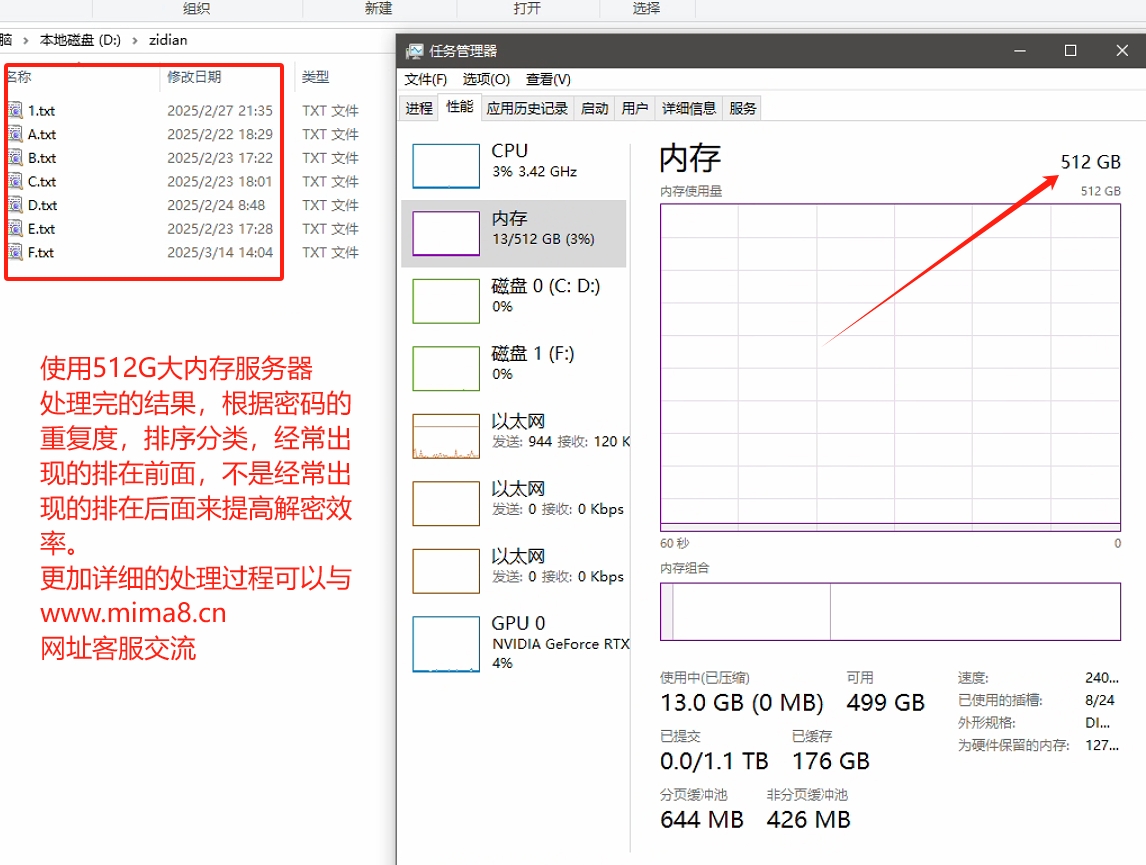
2T のテキスト型辞书ファイルの重复をフィルタリングすることは困难ですが、非常に必要な作业です。ツールとアルゴリズムを合理的に選択することで、重複コンテンツを効果的に削除し、辞書ファイルの品質と使用効率を向上させることができます。これは、パスワード クラッキングやこの辞書ファイルに基づくその他のアプリケーション シナリオの両方で非常に重要です。