 Belge Şifre Kurtarma Ustası
2T sözlüğünden duplikatları nasıl filtrelenir, büyük metin duplikatları nasıl filtrelenir
Şifre kırma veya veri işleme alanında, 2T metin tipi sözlük dosyasına sahip olmak oldukça güçlü bir kaynaktır. Ancak bu kadar büyük bir dosya genellikle büyük miktarda yinelenen veriye eğilimlidir; bu sadece gereksiz depolama alanı kaplamakla kalmaz, aynı zamanda şifre arama hızı gibi bu sözlük dosyasına dayalı sonraki işlemlerin verimliliğini de etkileyebilir. Bu nedenle, yinelenen içeriği etkili bir şekilde filtrelemek çok kritik bir adımdır.
Birincisi, çoğaltılan verilerin kaynaklarını ve etkilerini anlamak
Öncelikle neden bu kadar çok çoğaltılan verilerin üretildiğini anlamalıyız. Sözlük dosyasının oluşturulması sırasında, veriler birden fazla veri kaynağından toplanabilir ve bu veri kaynakları arasında kısmi örtüşme vardır. Örneğin, farklı kelime listelerinden, ortak şifre kümelerinden, çeşitli karakter kombinasyonlarının listelerinden vb. veri toplarken, bazı temel kelimeler veya basit şifre kombinasyonları birden fazla kaynakta mevcut olabilir.
Bu kopyalanan verilerin birçok olumsuz etkisi vardır. Depolama açısından bakıldığında, 2T'nin alanı zaten çok büyüktür. Çok sayıda yinelenen içerik varsa, değerli depolama alanının israfına eşdeğerdir. Bu sözlük dosyasını aslında şifre kırma veya diğer işlemler için kullanırken, yinelenen içerik gereksiz arama ve karşılaştırma işlemlerine neden olabilir. Örneğin, şifre kırma sırasında algoritmanın sözlükteki içeriği hedef şifreyle tek tek karşılaştırması gerekiyorsa, tekrarlanan içerik karşılaştırma sayısını artıracak ve böylece tüm kırma sürecini yavaşlatacaktır.
2. Metin işleme araçlarına dayalı filtreleme yöntemi
Windows sistemi altında araçları kullanın
-PowerShell
kullanın-Windows sisteminde PowerShell zengin metin işleme özellikleri sağlar. Tekrarlanan satırları kaldırmak için aşağıdaki PowerShell betiğini kullanabiliriz:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-not contains $line) {
$uniqueLines + = $line
{
```
Bu komut dosyası önce "dictionary.txt" deki tüm satırları "$lines" dizisine okur. Daha sonra, her satırı bir döngü yoluyla geçirin ve eğer bir satır yeni "$uniqueLines" dizisinde değilse, onu yeni diziye ekleyin. Son olarak, yeni dizideki içeriği "unique_dictionary.txt" e kaydedin.
Böl ve Böl Algoritması
-Sözlük dosyamız çok büyük (2T) olduğundan doğrudan işleme yetersiz bellek gibi sorunlarla karşılaşabilirsiniz. Böl ve feth algoritması bu sorunu çok iyi çözebilir. Bu büyük dosyayı birkaç küçük alt dosyaya ayırabiliriz. Örneğin, belirli bir satır sayısına veya dosya boyutuna göre bölünebiliriz.
-Ardından, her alt dosya için ayrı ayrı tekrar filtreleme yapın. İşlenmiş alt dosyaları tek bir dosyaya yeniden birleştirin. Birleştirme işlemi sırasında, farklı alt dosyalar arasında aynı içerik olabileceğinden, yinelenen içerik olup olmadığını tekrar kontrol etmeniz gerekir.
4. Filtreleme sonuçlarını doğrulayın
Tekrarlanan filtrelemeyi tamamladıktan sonra sonuçların doğru olup olmadığını doğrulamamız gerekir. Bazı satırları rastgele seçmek ve bu satırların orijinal dosyada ve filtrelenmiş dosyada ne zaman göründüğünü kontrol etmek gibi bazı basit yöntemler kullanabilirsiniz. Orijinal dosyada birden fazla kez ve filtrelenmiş dosyada yalnızca bir kez görünürse, filtreleme geçerlidir.
Ek olarak, orijinal ve filtrelenen dosyaların boyutlarını karşılaştırabilirsiniz. Filtrelenmiş dosya boyutu orijinal dosyadan önemli ölçüde küçükse ve sonraki testlerde (bu sözlük dosyasını düzgün çalışıp çalışmadığını ve var olması gereken şifreyi eksik etmediğini görmek için basit bir şifre arama testi yapmak için kullanmak gibi) normal performans gösteriyorsa, aynı zamanda tekrarlanan filtreleme çalışmalarının iyi sonuçlar elde ettiği anlamına da gelebilir.
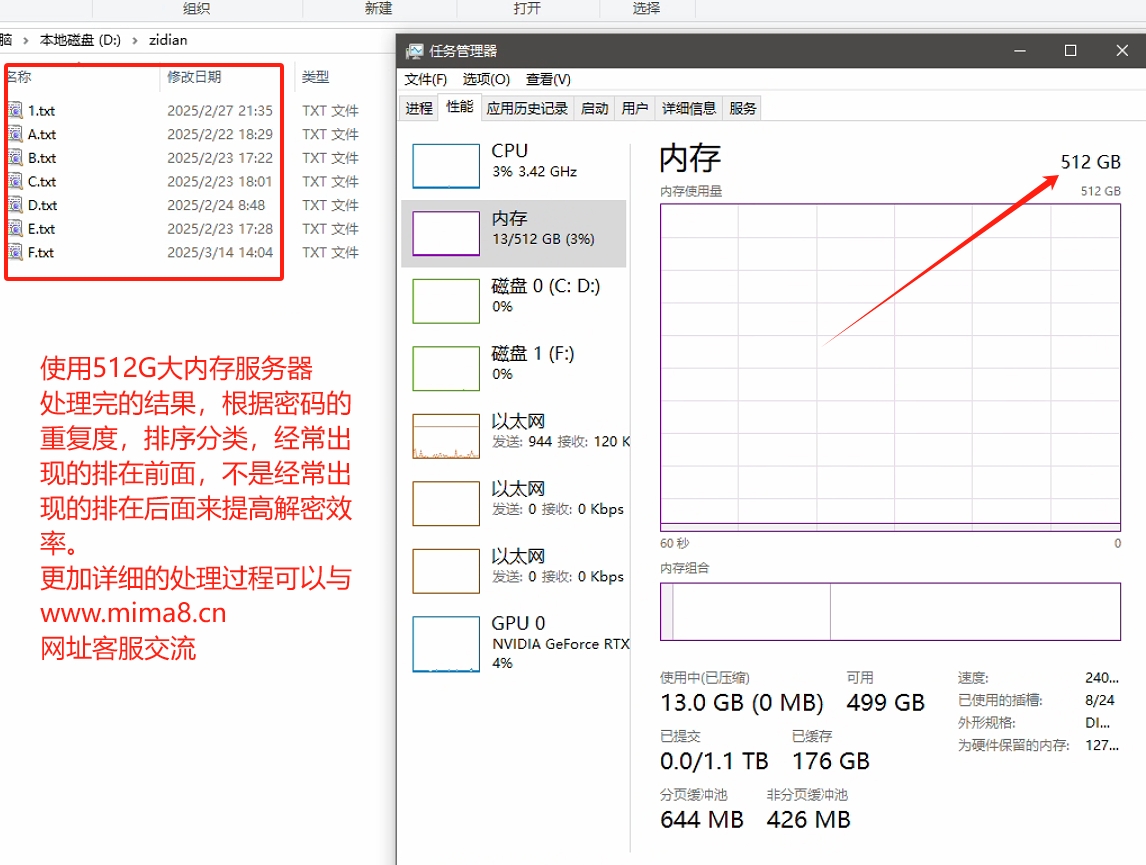
Sunucumuz 512G bellek ve yüksek hızlı NVMe protokollü sabit disk sunucusu kullanıyor. İşlemin başarılı bir şekilde tamamlanması yarım ay sürdü ve bir dizi verimli işleme komut dosyası keşfedildi. İhtiyacınız varsa iletişim kurmak için web sitesinin müşteri hizmetleriyle iletişime geçebilirsiniz. Tekrarlanan süreçte karşılaşılan tuzakları filtreleyin ve otomatik işleme komut dosyaları yazın!
2T'nin metin tipi sözlük dosyasındaki çoğaltıcı içeriği filtrelemek zorlu ama çok gerekli bir iştir. Araçları ve algoritmaları makul bir şekilde seçerek, yinelenen içeriği etkili bir şekilde ortadan kaldırabilir ve sözlük dosyalarının kalitesini ve kullanım verimliliğini artırabiliriz; bu, hem şifre kırmada hem de bu sözlük dosyasına dayalı diğer uygulama senaryolarında büyük önem taşımaktadır.