 Восстановление пароля
Как отфильтровать дублирующийся контент из словаря 2T
В области взлома паролей или обработки данных наличие файла словаря текстового типа 2T является довольно мощным ресурсом. Однако такой огромный файл часто подвержен большому количеству дублирующихся данных, что не только занимает ненужное место для хранения, но и может повлиять на эффективность последующих операций на основе этого файла словаря, например, на скорость поиска пароля. Поэтому эффективная фильтрация повторяющегося контента является очень важным шагом.
1. Понимание источников и последствий дублирующихся данных
Во-первых, мы должны понять, почему так много дублирующихся данных. В процессе построения файла словаря данные могут быть собраны из нескольких источников данных, и между этими источниками данных существует частичное перекрытие. Например, при сборе данных из различных списков слов, общих наборов паролей, различных списков комбинаций символов и т. Д. Некоторые основные слова или простые комбинации паролей могут существовать в нескольких источниках.
Эти дублирующие данные могут иметь много неблагоприятных последствий. С точки зрения хранения, пространство 2T уже очень велико, и если в нем много дублирующегося контента, это равносильно потере драгоценного места для хранения. При фактическом использовании этого файла словаря для взлома пароля или других операций повторяющийся контент приведет к ненужным операциям поиска и сравнения. Например, если при взломе пароля алгоритму необходимо сравнить содержимое словаря с целевым паролем один за другим, повторяющийся контент увеличит количество сравнений, тем самым замедляя весь процесс взлома.
II. Метод фильтрации на основе средств обработки текста
Использование инструментов под системами Windows
- Использование PowerShell
- В системах Windows PowerShell предоставляет богатые возможности обработки текста. Мы можем использовать следующий скрипт PowerShell для удаления дублирующихся строк:
```powershell
$lines = Get - Content "dictionary.txt"
$uniqueLines = @()
foreach ($line в $lines) {
if ($uniqueLines - не содержит $line) {
```
Этот сценарий сначала читает все строки из "dictionary.txt" в массив "$lines". Затем каждая строка проходит через цикл, и если строка отсутствует в новом массиве «$ uniqueLines», она добавляется в новый массив. Наконец, сохраните содержимое нового массива в «unique_dictionary.txt».
Алгоритм разделяй и властвуй
- Поскольку файлы нашего словаря очень большие (2T), прямая обработка может столкнуться с такими проблемами, как нехватка памяти. Алгоритм «Разделяй и властвуй» хорошо решает эту проблему. Мы можем разделить этот большой файл на несколько меньших подфайлов. Например, мы можем разделить его по определенному количеству строк или размеру файла.
- Затем каждый подфайл фильтруется повторно отдельно. Объедините обработанные подфайлы в один файл. В процессе слияния также необходимо еще раз проверить на наличие дубликатов, так как одно и то же содержимое может присутствовать между разными подфайлами.
4. Проверьте результаты фильтрации
После завершения повторной фильтрации нам необходимо проверить правильность результатов. Вы можете использовать несколько простых методов, таких как случайное выделение строк и проверка количества появлений этих строк в исходном файле и отфильтрованном файле. Если он появляется несколько раз в исходном файле и только один раз в отфильтрованном файле, фильтрация действительна.
Кроме того, вы можете сравнить размер исходного файла и отфильтрованного файла. Если размер отфильтрованного файла значительно меньше, чем у исходного файла, и он работает нормально в последующих тестах (например, с использованием этого файла словаря для выполнения простого теста поиска пароля, чтобы проверить, работает ли он правильно и не пропускает ли пароль, который должен существовать), это также можно объяснить. Повторная работа по фильтрации дала хорошие результаты.
На нашем сервере используется память 512 ГБ и высокоскоростной сервер жесткого диска по протоколу NVMe. Потребовалось полмесяца, чтобы успешно завершить обработку и разработать набор эффективных сценариев обработки. Если у вас есть какие-либо потребности, вы можете связаться со службой поддержки клиентов веб-сайта для общения и фильтрации. Подводные камни, возникшие в процессе повторения, и написание сценариев автоматической обработки!
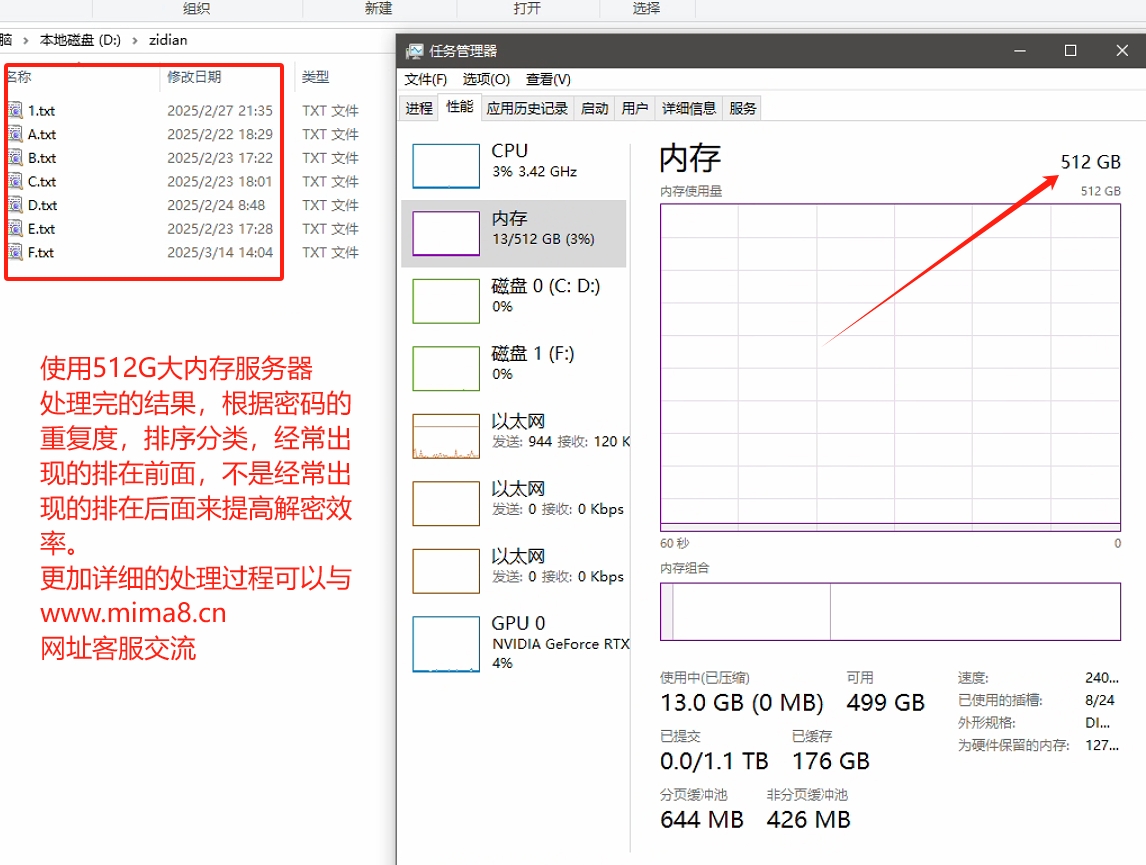
Фильтрация дубликатов в файле словаря типов текста 2T — сложная, но очень необходимая задача. Разумно выбирая инструменты и алгоритмы, мы можем эффективно удалить дублирующийся контент и повысить качество и эффективность использования файлов словаря, что имеет большое значение как при взломе паролей, так и в других сценариях приложений, основанных на этом файле словаря.