 Maestru de recuperare a parolei documentului
Cum să filtrezi conținutul duplicat din dicționarul 2T, textul supradimensionat filtrează conținutul duplicat
În domeniul spargerii parolelor sau al procesării datelor, deținerea unui fișier dicționar de tip text 2T este o resursă destul de puternică. Cu toate acestea, un fișier atât de mare este adesea predispus la cantități mari de date duplicate, ceea ce nu numai că va ocupa spațiu de stocare inutil, dar poate afecta și eficiența operațiunilor ulterioare bazate pe acest fișier de dicționar, cum ar fi viteza de căutare a parolei. Prin urmare, filtrarea eficientă a conținutului duplicat este un pas foarte critic.
1. Înțelegeți sursele și efectele datelor duplicate
În primul rând, trebuie să înțelegem de ce există atât de multe date duplicate. În timpul construirii unui fișier de dicționar, datele pot fi colectate din mai multe surse de date și există o suprapunere parțială între aceste surse de date. De exemplu, atunci când colectați date din diferite liste de cuvinte, seturi comune de parole, liste de diferite combinații de caractere etc., unele cuvinte de bază sau combinații simple de parole pot exista în mai multe surse.
Aceste date duplicate pot avea multe efecte adverse. Din punct de vedere al stocării, spațiul 2T este deja foarte mare Dacă există o mulțime de conținut duplicat, echivalează cu o risipă de spațiu de stocare prețios. Când utilizați efectiv acest fișier de dicționar pentru spargerea parolei sau alte operații, conținutul duplicat poate duce la operațiuni de căutare și comparare inutile. De exemplu, dacă algoritmul trebuie să compare conținutul din dicționar cu parola țintă una câte una în timpul spargerii parolei, conținutul duplicat va crește numărul de comparații, încetinind astfel întregul proces de spargere.
2. Metoda de filtrare bazată pe instrumente de procesare a textului
Utilizați instrumentele sub sistemul Windows
-Utilizați PowerShell
-În sistemul Windows, PowerShell oferă o mulțime de capacități de procesare a textului. Putem folosi următorul script PowerShell pentru a elimina rândurile duplicate:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Acest script citește mai întâi toate rândurile din „dictionary.txt "într-o matrice „$lines". Apoi, traversați fiecare rând printr-o buclă și, dacă un rând nu se află în noua matrice "$ uniqueLines", adăugați-l la noua matrice. În cele din urmă, salvați conținutul noii matrice în "unique_dictionary.txt".
Divide and conquer algorithm
-Deoarece fișierele noastre de dicționar sunt foarte mari (2T), procesarea directă poate întâmpina probleme precum memoria insuficientă. Algoritmul de împărțire și cucerire poate rezolva foarte bine această problemă. Putem împărți acest fișier mare în mai multe subfișiere mai mici. De exemplu, îl putem împărți în funcție de un anumit număr de linii sau de dimensiunea fișierului.
-Apoi, filtrarea repetată se efectuează separat pentru fiecare subfișier. Recombinați subfișierele procesate într-un singur fișier. În timpul procesului de fuziune, trebuie să verificați din nou dacă există conținut duplicat, deoarece același conținut poate exista între diferite subfișiere.
4. Verificați rezultatele filtrării
După finalizarea filtrării repetate, trebuie să verificăm dacă rezultatele sunt corecte. Puteți utiliza câteva metode simple, cum ar fi selectarea aleatorie a unor linii, pentru a verifica numărul de apariții ale acestor linii în fișierul original și în fișierul filtrat. Dacă apare de mai multe ori în fișierul original și o singură dată în fișierul filtrat, filtrarea este validă.
În plus, este posibil să comparați dimensiunile fișierelor originale și ale fișierelor filtrate. Dacă dimensiunea fișierului filtrat este semnificativ mai mică decât fișierul original și funcționează normal în testele ulterioare (cum ar fi utilizarea acestui fișier de dicționar pentru un simplu test de căutare a parolei pentru a vedea dacă funcționează corect și nu lipsește parola care ar trebui să existe), poate indica, de asemenea, repetarea Lucrarea de filtrare a obținut rezultate mai bune.
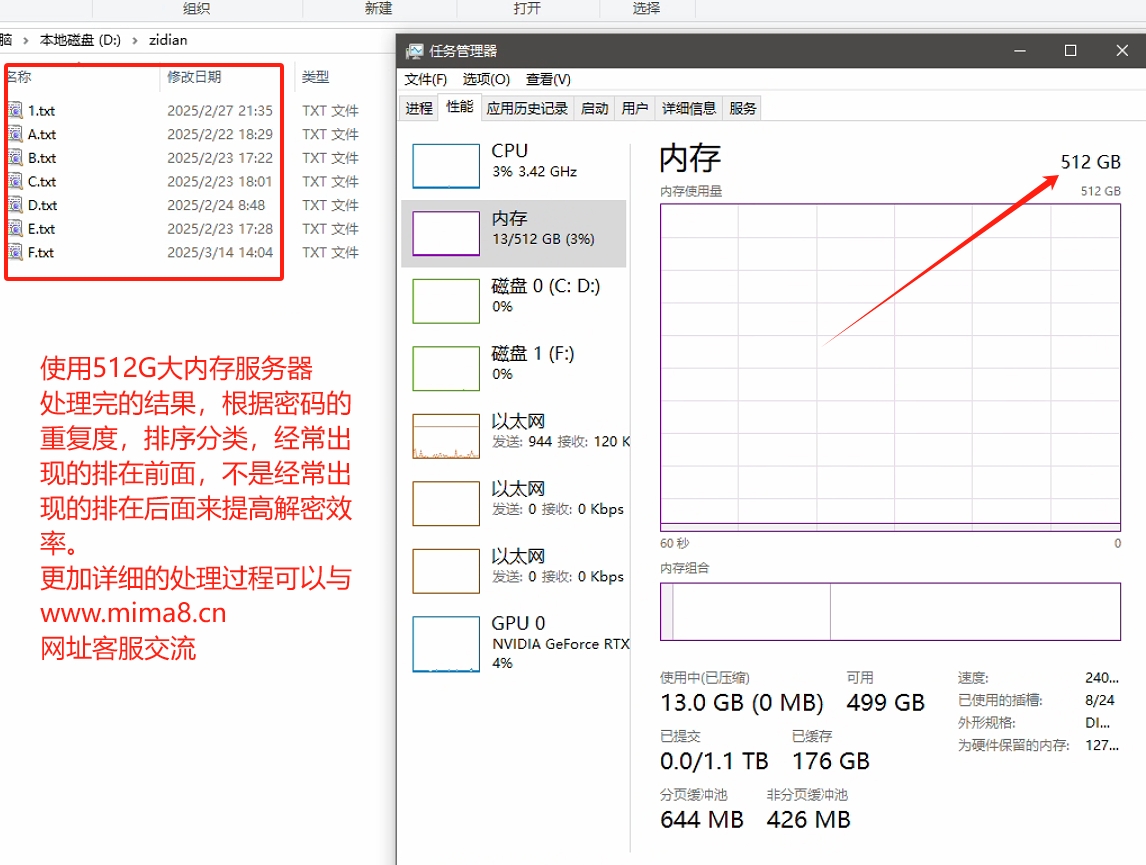
Serverul nostru folosește memorie de 512G și un server de hard disk cu protocol NVMe de mare viteză. A durat o jumătate de lună pentru a finaliza procesarea cu succes și a găsit un set de scripturi de procesare eficiente contactați serviciul pentru clienți al site-ului web pentru a comunica, filtrați capcanele întâlnite în procesul de repetare și scrieți scripturi de procesare automată!
Filtrarea conținutului duplicat în fișierele dicționarului de tip text 2T este o sarcină dificilă, dar foarte necesară. Prin selecția rezonabilă a instrumentelor și algoritmilor, putem elimina în mod eficient conținutul duplicat și putem îmbunătăți calitatea și eficiența utilizării fișierelor de dicționar, ceea ce are o importanță importantă atât în spargerea parolelor, cât și în alte scenarii de aplicații bazate pe acest fișier de dicționar.