 Dokument Passwort Wiederherstellung Master
Wie man Duplikate aus 2T-Wörterbuch filtert, Extra-Large-Text-Duplikate filtert
Im Bereich des Passwortknackens oder der Datenverarbeitung ist der Besitz einer 2T-Texttyp-Wörterbuchdatei eine ziemlich leistungsstarke Ressource. Eine so große Datei ist jedoch häufig anfällig für eine große Menge duplizierter Daten, was nicht nur unnötigen Speicherplatz einnimmt, sondern auch die Effizienz nachfolgender Vorgänge auf der Grundlage dieser Wörterbuchdatei beeinträchtigen kann, z. B. die Geschwindigkeit der Passwortsuche. Daher ist das effektive Filtern von Duplikaten ein sehr kritischer Schritt.
1. Verstehen Sie die Quellen und Auswirkungen duplizierter Daten
Zunächst müssen wir verstehen, warum so viele duplizierte Daten entstehen. Während des Erstellungsprozesses einer Wörterbuchdatei können Daten aus mehreren Datenquellen gesammelt werden, und es gibt teilweise Überschneidungen zwischen diesen Datenquellen. Wenn beispielsweise Daten aus verschiedenen Wortlisten, gängigen Passwortsätzen, Listen verschiedener Zeichenkombinationen usw. gesammelt werden, können einige grundlegende Wörter oder einfache Passwortkombinationen in mehreren Quellen vorhanden sein.
Diese duplizierten Daten haben zahlreiche nachteilige Auswirkungen. Aus Speichersicht ist der Platz bei 2T bereits sehr groß, und wenn sich viel doppelter Inhalt darin befindet, ist dies eine Verschwendung von wertvollem Speicherplatz. Wenn Sie diese Wörterbuchdatei tatsächlich zum Knacken von Passworten oder anderen Vorgängen verwenden, kann duplizierter Inhalt zu unnötigen Suche-und Vergleichsvorgängen führen. Wenn der Algorithmus beispielsweise beim Passwortknacken den Inhalt im Wörterbuch mit dem Zielpasswort nacheinander vergleichen muss, erhöht der wiederholte Inhalt die Anzahl der Vergleiche und verlangsamt so den gesamten Knackprozess.
2. Filtermethode basierend auf Textverarbeitungstools
Verwenden Sie Tools unter Windows-Systemen
-Verwenden Sie PowerShell
-In Windows-Systemen bietet PowerShell umfangreiche Textverarbeitungsfunktionen. Wir können das folgende PowerShell-Skript verwenden, um doppelte Zeilen zu entfernen:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Dieses Skript liest zuerst alle Zeilen in "dictionary.txt" in ein Array "$lines". Dann wird jede Zeile durch eine Schleife durchlaufen, und wenn sich eine Zeile nicht in dem neuen Array "$uniqueLines" befindet, wird sie zu diesem neuen Array hinzugefügt. Schließlich speichern Sie den Inhalt des neuen Arrays in "unique_dictionary.txt".
Teilen und Herrschen Algorithmus
-Da unsere Wörterbuchdateien sehr groß sind (2T), kann die direkte Verarbeitung auf Probleme wie unzureichenden Speicher stoßen. Dieser Algorithmus zum Teilen und Erobern kann dieses Problem sehr gut lösen. Wir können diese große Datei in mehrere kleinere Unterdateien aufteilen. Zum Beispiel können wir sie nach einer bestimmten Anzahl von Zeilen oder Dateigröße aufteilen.
-Dann wird die Filterung für jede Unterdatei getrennt wiederholt. Fügen Sie die verarbeiteten Unterdateien wieder zu einer Datei zusammen. Während des Zusammenführungsprozesses müssen Sie auch erneut überprüfen, ob Duplikate vorhanden sind, da der gleiche Inhalt zwischen verschiedenen Unterdateien vorhanden sein kann.
4. Überprüfen Sie die Filterergebnisse
Nach Abschluss der wiederholten Filterung müssen wir überprüfen, ob die Ergebnisse korrekt sind. Sie können einige einfache Methoden verwenden, z. B. zufällig Zeilen auswählen und überprüfen, wie oft diese Zeilen in der Originaldatei und der gefilterten Datei auftreten. Wenn es mehrmals in der Originaldatei und nur einmal in der gefilterten Datei erscheint, ist die Filterung wirksam.
Außerdem ist es möglich, die Größe der ursprünglichen und gefilterten Dateien zu vergleichen. Wenn die Größe der gefilterten Datei deutlich kleiner ist als die Originaldatei und sie bei nachfolgenden Tests (z. B. Verwendung dieser Wörterbuchdatei für einen einfachen Passwortsuchtest, um zu sehen, ob sie ordnungsgemäß funktioniert und kein Passwort fehlt, das vorhanden sein sollte) normal funktioniert, kann dies auch bedeuten, dass die Wiederholung der Filterarbeit gute Ergebnisse erzielt hat.
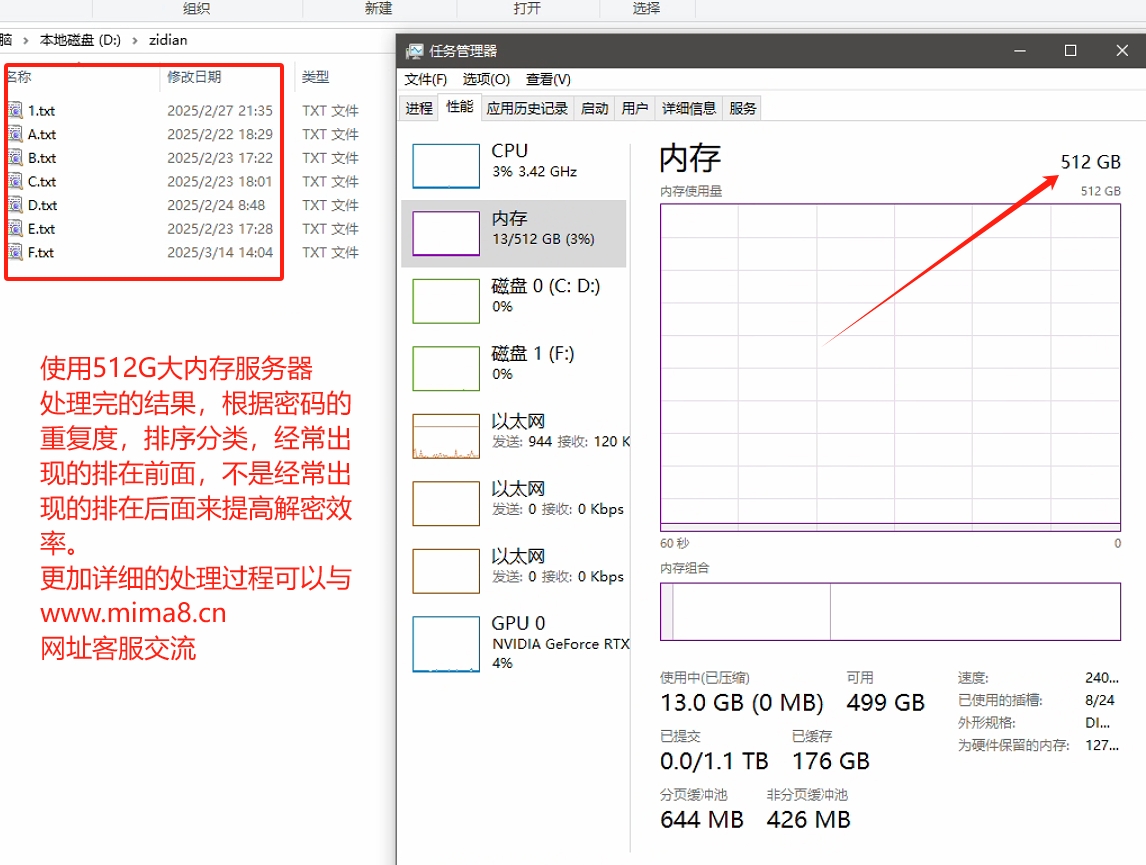
Unser Server verwendet 512 G-Speicher und einen Hochgeschwindigkeits-NVMe-Protokoll-Festplattenserver. Es dauerte einen halben Monat, um die Verarbeitung erfolgreich abzuschließen, und wir haben eine Reihe effizienter Verarbeitungsskripte entwickelt. Wenn Sie Anforderungen haben, können Sie sich an den Kundendienst der Website wenden, um zu kommunizieren. Filtern Sie Fallstricke, die während des Wiederholungsprozesses aufgetreten sind, und schreiben Sie automatische Verarbeitungsskripte!
Das Filtern von Duplikaten in Texttypen-Wörterbuchdateien von 2T ist eine herausfordernde, aber sehr notwendige Aufgabe. Durch eine angemessene Auswahl von Tools und Algorithmen können wir doppelte Inhalte effektiv entfernen und die Qualität und Nutzungseffizienz von Wörterbuchdateien verbessern, was sowohl beim Kennwortknacken als auch bei anderen Anwendungsszenarien auf der Grundlage dieser Wörterbuchdatei von großer Bedeutung ist.