 Document Wachtwoord Herstel Master
Hoe te filteren dubbele inhoud van 2T woordenboek, extra grote tekst filteren dubbele inhoud
Op het gebied van wachtwoordkraken of gegevensverwerking is het bezitten van een 2T-woordenboekbestand van teksttype een behoorlijk krachtige bron. Een dergelijk groot bestand is echter vaak gevoelig voor een grote hoeveelheid dubbele gegevens, wat niet alleen onnodige opslagruimte in beslag neemt, maar ook de efficiëntie van daaropvolgende bewerkingen op basis van dit woordenboekbestand kan beïnvloeden, zoals de snelheid van het zoeken naar wachtwoorden. Daarom is het effectief filteren van dubbele inhoud een zeer cruciale stap.
1. Begrijp de bron en impact van dubbele gegevens
Allereerst moeten we begrijpen waarom er zoveel dubbele gegevens worden gegenereerd. Tijdens het bouwen van een woordenboekbestand kunnen gegevens worden verzameld uit meerdere gegevensbronnen en er is gedeeltelijke overlap tussen deze gegevensbronnen. Bij het verzamelen van gegevens uit verschillende woordlijsten, gemeenschappelijke wachtwoordsets, lijsten met verschillende tekencombinaties, enz., Kan er bijvoorbeeld een aantal basiswoorden of eenvoudige wachtwoordcombinaties in meerdere bronnen aanwezig zijn.
Deze dubbele gegevens hebben veel nadelige effecten. Vanuit opslagoogpunt is de ruimte van 2T al erg groot. Als er veel dubbele inhoud in zit, komt dit neer op verspilling van kostbare opslagruimte. Wanneer u dit woordenboekbestand daadwerkelijk gebruikt voor het kraken van wachtwoorden of andere bewerkingen, kan dubbele inhoud onnodige zoek-en vergelijkingsbewerkingen veroorzaken. Als het algoritme bijvoorbeeld bij het kraken van wachtwoorden de inhoud in het woordenboek één voor één met het doelwachtwoord moet vergelijken, zal de dubbele inhoud het aantal vergelijkingen vergroten, waardoor het hele krakproces wordt vertraagd.
2. Filtermethode op basis van tekstverwerkingstools
Gebruik tools onder Windows-systeem
-Gebruik PowerShell
-In Windows-systemen biedt PowerShell rijke tekstverwerkingsmogelijkheden. We kunnen het volgende PowerShell-script gebruiken om dubbele rijen te verwijderen:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Dit script leest eerst alle regels in "dictionary.txt" naar een array "$lines". Haal vervolgens elke rij door een lus en als een rij niet in de nieuwe array "$ uniqueLines" zit, voeg deze toe aan de nieuwe array. Sla ten slotte de inhoud van de nieuwe array op in "unique_dictionary.txt".
Split and Conquer Algorithm
-Omdat onze woordenboekbestanden erg groot zijn (2T), kan directe verwerking problemen ondervinden zoals onvoldoende geheugen. Het split-and-conquer-algoritme kan dit probleem goed oplossen. We kunnen dit grote bestand verdelen in verschillende kleinere subbestanden. We kunnen het bijvoorbeeld splitsen op basis van een bepaald aantal regels of bestandsgrootte.
-Vervolgens wordt elk subbestand afzonderlijk herhaald. Voeg de verwerkte subbestanden opnieuw samen in één bestand. Tijdens het samenvoegen moet u ook opnieuw controleren op dubbele inhoud, omdat dezelfde inhoud tussen verschillende subbestanden kan bestaan.
4. Controleer de filterresultaten
Na het voltooien van de herhaalde filtering moeten we verifiëren of de resultaten correct zijn. U kunt enkele eenvoudige methoden gebruiken, zoals het willekeurig selecteren van enkele regels om te controleren hoe vaak deze regels in het originele bestand en het gefilterde bestand voorkomen. Als het meerdere keren verschijnt in het oorspronkelijke bestand en slechts één keer verschijnt in het gefilterde bestand, is het filteren geldig.
Bovendien is het mogelijk om de grootte van het originele bestand en het gefilterde bestand te vergelijken. Als de gefilterde bestandsgrootte aanzienlijk kleiner is dan het originele bestand en het goed presteert in daaropvolgende tests (zoals het gebruik van dit woordenboekbestand voor een eenvoudige wachtwoordzoektest om te zien of het goed werkt en het wachtwoord dat zou moeten bestaan niet wordt gemist), kan dit ook betekenen dat het herhaalde filterwerk goede resultaten heeft opgeleverd.
Onze server maakt gebruik van 512G geheugen en een snelle harde schijfserver met NVMe-protocol. Het duurde een halve maand om de verwerking succesvol te voltooien en een reeks efficiënte verwerkingsscripts te ontwikkelen. Als u enige typebehoeften heeft, kunt u contact opnemen met de klantenservice van de website om te communiceren. Filter de valkuilen die tijdens het herhaalde proces worden aangetroffen en schrijf automatische verwerkingsscripts!
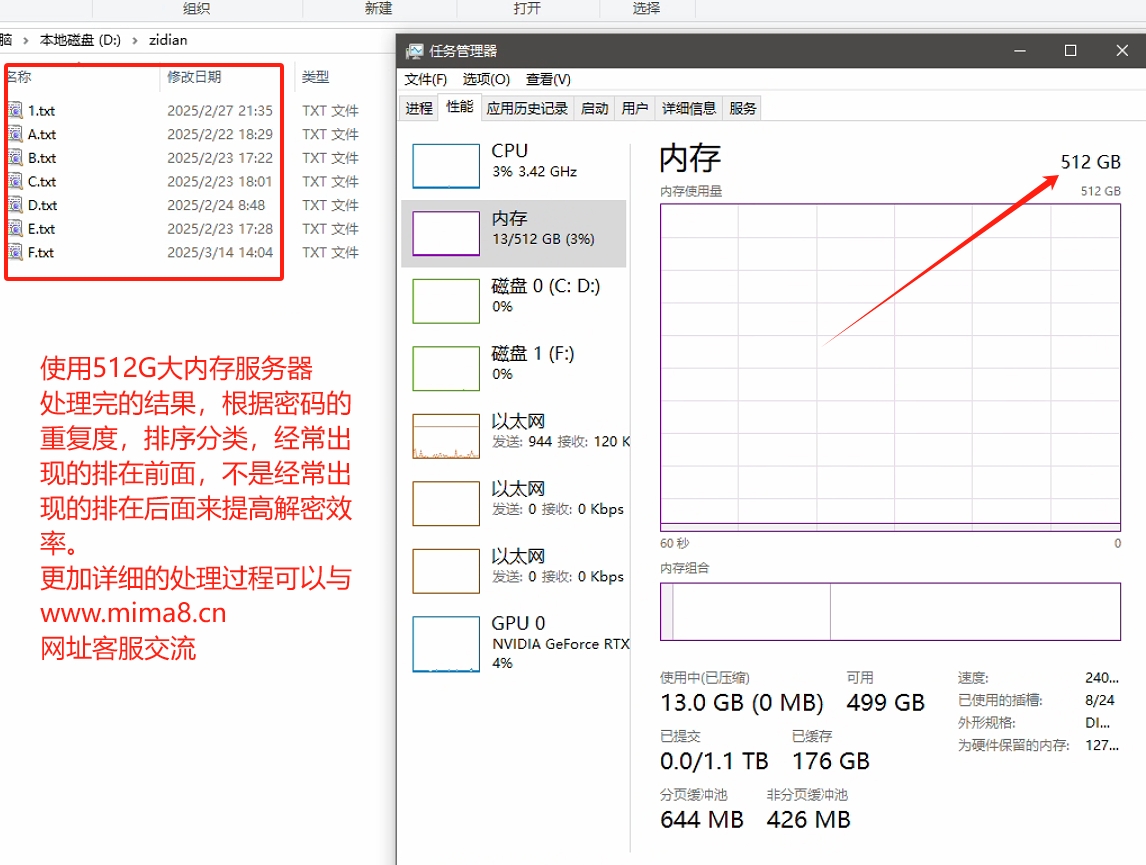
Het filteren van dubbele inhoud in een woordenboekbestand van het teksttype van 2T is een uitdagende maar zeer noodzakelijke taak. Door redelijke tools en algoritmen te selecteren, kunnen we dubbele inhoud effectief verwijderen en de kwaliteit en gebruiksefficiëntie van woordenboekbestanden verbeteren, wat van groot belang is bij het kraken van wachtwoorden of andere toepassingsscenario's op basis van dit woordenboekbestand.