 Dokumentum jelszó helyreállítási mester
Hogyan szűrjük a duplikált tartalmat a 2T szótárból, szűrjük a duplikált tartalmat túlméretezett szövegből
A jelszófeltörés vagy az adatfeldolgozás területén egy 2T szövegtípusú szótárfájl meglehetősen hatékony erőforrás. Egy ilyen hatalmas fájl azonban gyakran hajlamos nagy mennyiségű ismétlődő adatra, ami nemcsak felesleges tárhelyet foglal el, hanem befolyásolhatja az ezen a szótárfájlon alapuló későbbi műveletek hatékonyságát is, például a jelszókeresés sebességét. Ezért a duplikált tartalom hatékony szűrése nagyon kritikus lépés.
I. A duplikált adatok forrásainak és hatásainak megértése
Először is meg kell értenünk, miért keletkezik ennyi duplikált adat. A szótár fájl létrehozása során több adatforrásból is összegyűjthetők az adatok, és ezek az adatforrások között részleges átfedés van. Például, amikor adatokat gyűjtenek különböző szólistákból, közös jelszókészletekből, különböző karakterkombinációk listáiból stb., Néhány alapvető szó vagy egyszerű jelszókombináció több forrásban is létezhet.
Ezeknek a duplikált adatoknak számos káros hatása van. Tárolási szempontból a 2T már nagyon nagy a helye, és ha rengeteg ismétlődő tartalom van benne, az értékes tárhely elpazarlásának felel meg. Ha ténylegesen használja ezt a szótár fájlt a jelszó feltörésére vagy más műveletekre, a duplikált tartalom szükségtelen keresési és összehasonlítási műveletekhez vezethet. Például, ha a jelszó feltörése során az algoritmusnak egyenként össze kell hasonlítania a szótár tartalmát a céljelszóval, az ismétlődő tartalom növeli az összehasonlítások számát, ezáltal lelassítva a teljes feltörési folyamatot.
2. Szövegfeldolgozó eszközökön alapuló szűrési módszer
Eszközök használata Windows rendszerben
-PowerShell
használata-Windows rendszerekben a PowerShell gazdag szövegfeldolgozási funkciókat biztosít. A következő PowerShell szkriptet használhatjuk az ismétlődő sorok eltávolításához:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Ez a szkript először a "dictionary.txt" összes sorát beolvassa egy "$lines" tömbbe. Ezután keresse át az egyes sorokat egy hurokkal, és ha egy sor nincs az új "$ uniqueLines" tömbben, adja hozzá az új tömbhöz. Végül mentse el az új tömb tartalmát az "unique_dictionary.txt"-be.
Split and Conquer Algorithm
-Mivel a szótárfájlunk nagyon nagy (2T), a közvetlen feldolgozás olyan problémákkal találkozhat, mint az elégtelen memória. A megosztás és meghódítás algoritmusa jól megoldja ezt a problémát. Ezt a nagy fájlt több kisebb alfájlra oszthatjuk. Például egy bizonyos sorszám vagy fájlméret szerint oszthatjuk.
-Ezután ismételje meg az egyes alfájlok szűrését külön-külön. A feldolgozott alfájlok egyesítése egyetlen fájlba. Az egyesítés során újra ellenőriznie kell, hogy vannak-e duplikált tartalmak, mivel ugyanaz a tartalom létezhet a különböző alfájlok között.
4. Ellenőrizze a szűrési eredményeket
Az ismételt szűrés befejezése után ellenőrizni kell, hogy az eredmények helyesek-e. Használhat néhány egyszerű módszert, például véletlenszerűen kiválaszthat néhány sort, hogy ellenőrizze, hányszor jelennek meg ezek a sorok az eredeti fájlban és a szűrt fájlban. Ha többször jelenik meg az eredeti fájlban, és csak egyszer jelenik meg a szűrt fájlban, akkor a szűrés hatékony.
Ezenkívül összehasonlítható az eredeti és a szűrt fájlok mérete is. Ha a szűrt fájl mérete lényegesen kisebb, mint az eredeti fájl, és normálisan működik a későbbi tesztekben (például használja ezt a szótárfájlt egy egyszerű jelszókeresési teszthez, hogy megnézze, működik-e megfelelően, és nincs-e hiányzó jelszó, amelynek léteznie kellene), azt is jelezheti, hogy a szűrési munka jó eredményeket ért el.
Szerverünk 512G memóriát és nagy sebességű NVMe protokollú merevlemez-szervert használ. Fél hónapba telt a sikeres feldolgozás befejezése, és egy hatékony feldolgozási szkript-készlet kidolgozása, ha bármilyen típusra van szüksége lépjen kapcsolatba a weboldal ügyfélszolgálatával, hogy kommunikáljon az ismétlődő folyamat során felmerült buktatókkal, és írjon automatikus feldolgozási szkripteket!
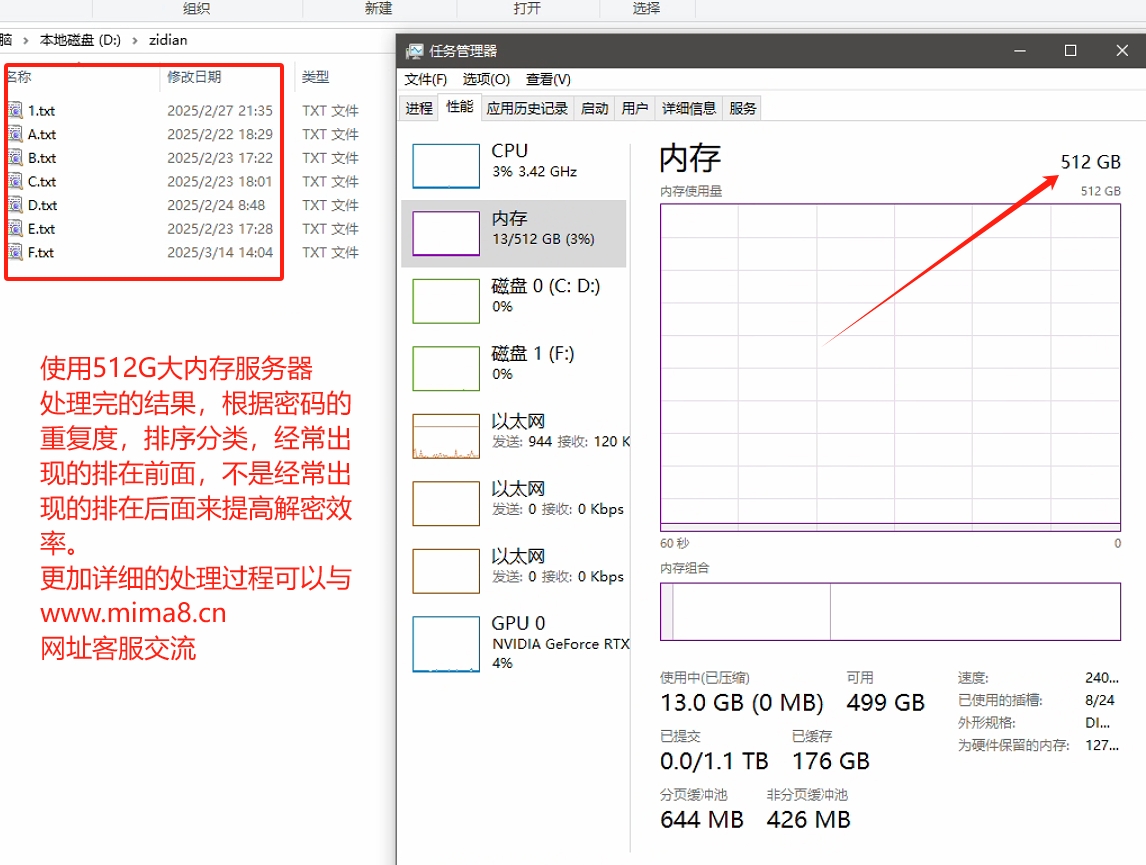
Kihívást jelentő, de nagyon szükséges munka a 2T szövegtípusú szótár fájljainak ismétlődő tartalmának kiszűrése. Az eszközök és algoritmusok ésszerű kiválasztásával hatékonyan eltávolíthatjuk a duplikált tartalmakat, javíthatjuk a szótárfájlok minőségét és hatékonyságát, ami nagy jelentőséggel bír mind a jelszófeltörésben, mind más, ezen a szótárfájlon alapuló alkalmazási forgatókönyvekben.