 Recuperação de senha
Como filtrar conteúdo duplicado do dicionário 2T, filtro de texto extra grande para duplicado
No campo de quebra de senhas ou processamento de dados, ter um arquivo de dicionário de tipo texto 2T é um recurso bastante poderoso. No entanto, um arquivo tão grande geralmente contém uma grande quantidade de dados duplicados, o que não apenas ocupa espaço de armazenamento desnecessário, mas também pode afetar a eficiência das operações subsequentes com base neste arquivo de dicionário, como a velocidade de pesquisa de senha. Portanto, filtrar efetivamente o conteúdo duplicado é uma etapa muito crítica.
1. Compreender a fonte e o impacto de dados duplicados
Primeiro, precisamos entender por que tantos dados duplicados são gerados. Durante a construção de um arquivo de dicionário, os dados podem ser coletados de várias fontes de dados e existem sobreposições parciais entre essas fontes de dados. Por exemplo, ao coletar dados de diferentes listas de palavras, conjuntos de senhas comuns, listas de várias combinações de caracteres, etc., algumas palavras básicas ou combinações simples de senhas podem existir em várias fontes.
Esses dados duplicados podem ter muitos efeitos adversos. Do ponto de vista do armazenamento, o espaço do 2T já é muito grande e, se houver muito conteúdo duplicado, equivale a um desperdício de espaço de armazenamento valioso. Ao realmente usar este arquivo de dicionário para quebrar senhas ou outras operações, conteúdo duplicado levará a operações de pesquisa e comparação desnecessárias. Por exemplo, se durante a quebra de senha, o algoritmo precisar comparar o conteúdo do dicionário com a senha de destino, um por um, o conteúdo duplicado aumentará o número de comparações, retardando assim todo o processo de quebra.
II. Método de filtragem baseado em ferramentas de processamento de texto
Use ferramentas no sistema Windows
-Use PowerShell
-No sistema Windows, PowerShell fornece ricos recursos de processamento de texto. Podemos usar o seguinte script PowerShell para remover linhas duplicadas:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Este script primeiro lê todas as linhas em "dictionary.txt" para um array "$lines". Em seguida, percorra cada linha em um loop e, se uma linha não estiver no novo array "$uniqueLines", adicione-a a esse novo array. Finalmente, salve o conteúdo da nova matriz em "unique_dictionary.txt".
Algoritmo de dividir e conquistar
-Como nosso arquivo de dicionário é muito grande (2T), o processamento direto pode encontrar problemas como memória insuficiente. O algoritmo de dividir e conquistar pode resolver esse problema muito bem. Podemos dividir esse arquivo grande em vários subarquivos menores. Por exemplo, podemos dividir de acordo com um determinado número de linhas ou tamanho do arquivo.
-Em seguida, a filtragem é repetida para cada subarquivo separadamente. Recombine os subarquivos processados em um único arquivo. Durante o processo de mesclagem, você também precisa verificar novamente se há conteúdo duplicado, pois o mesmo conteúdo pode existir entre diferentes subarquivos.
4. Verifique os resultados da filtragem
Depois de concluir a filtragem repetida, precisamos verificar se os resultados estão corretos. Você pode usar alguns métodos simples, como extrair aleatoriamente algumas linhas e verificar o número de vezes que essas linhas aparecem no arquivo original e no arquivo filtrado. Se aparecer várias vezes no arquivo original e apenas uma vez no arquivo filtrado, significa que a filtragem é válida.
Além disso, é possível comparar o tamanho do arquivo original e do arquivo filtrado. Se o tamanho do arquivo filtrado for significativamente menor que o arquivo original e funcionar normalmente em testes subsequentes (como usar este arquivo de dicionário para um teste simples de busca de senha para ver se ele funciona corretamente e não perde a senha que deveria existir), também pode indicar repetição O trabalho de filtragem alcançou bons resultados.
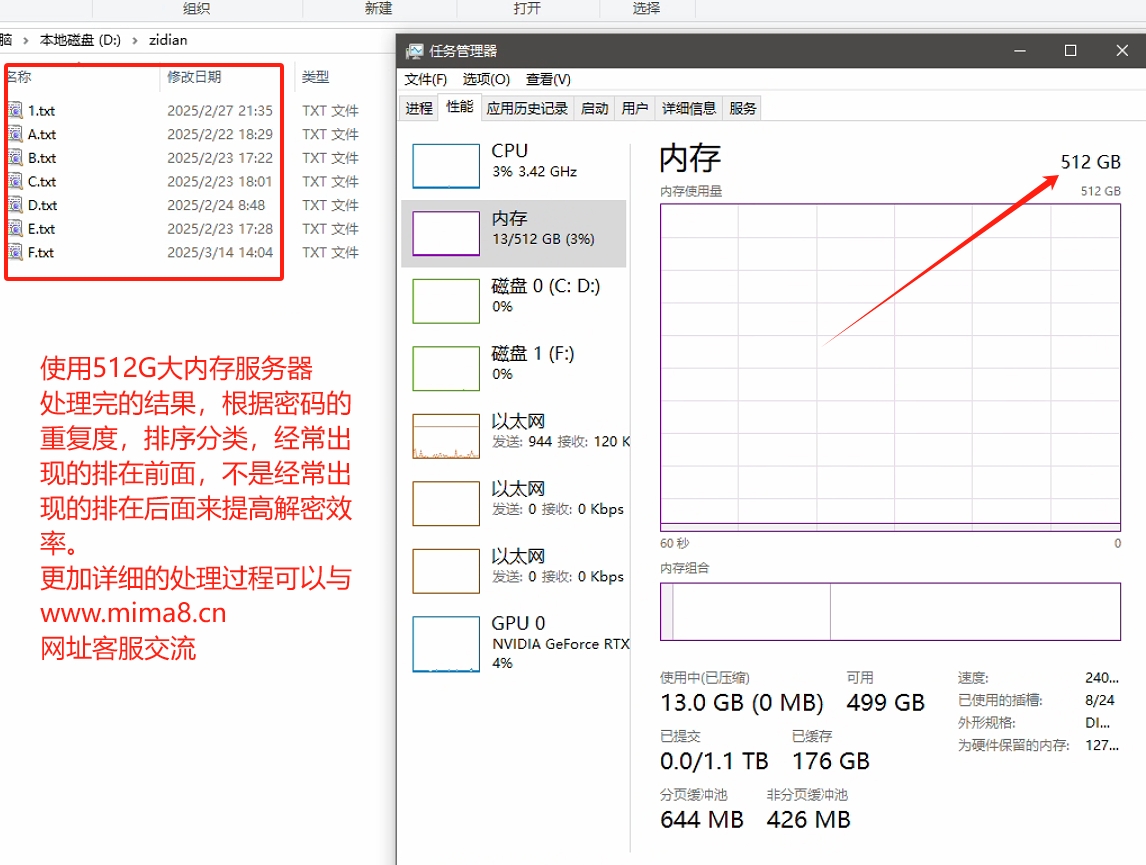
Nosso servidor usa memória de 512G e um servidor de disco rígido com protocolo NVMe de alta velocidade. Demorou meio mês para concluir o processamento com sucesso e descobrir um conjunto de scripts de processamento eficientes. Se você tiver alguma necessidade, você pode entrar em contato com o atendimento ao cliente do site para se comunicar e filtrar as armadilhas encontradas no processo de repetição e escrever scripts de processamento automático!
Filtrar conteúdo duplicado em um arquivo de dicionário de tipo de texto de 2T é um trabalho desafiador, mas muito necessário. Ao selecionar ferramentas e algoritmos razoavelmente, podemos remover efetivamente conteúdo duplicado e melhorar a qualidade e a eficiência do uso dos arquivos de dicionário, o que é de grande importância tanto na quebra de senhas quanto em outros cenários de aplicação baseados neste arquivo de dicionário.