 Dokument adgangskode gendannelse mester
Sådan filtrerer du duplikater fra 2T ordbog, ekstra stor tekst filtrerer duplikater
Inden for adgangskodeknækning eller databehandling er det en ret kraftfuld ressource at have en 2T teksttype ordbogsfil. En så stor fil er dog ofte tilbøjelig til at indeholde en stor mængde duplikerede data, hvilket ikke kun vil optage unødvendig lagerplads, men også kan påvirke effektiviteten af efterfølgende operationer baseret på denne ordbogsfil, såsom hastigheden af adgangskodesøgning. Derfor er effektivt filtrering af duplikatindhold et meget kritisk trin.
1. Forstå kilden og virkningen af duplikerede data
Først skal vi forstå, hvorfor der er så mange duplikerede data. Under opbygningen af en ordbogsfil kan data indsamles fra flere datakilder, og der er delvis overlapning mellem disse datakilder. For eksempel, når du indsamler data fra forskellige ordlister, fælles adgangskodesæt, forskellige tegnkombinationslister osv., Kan nogle grundlæggende ord eller enkle adgangskodekombinationer eksistere i flere kilder.
Disse duplikerede data har mange negative virkninger. Fra et lagersynspunkt er pladsen i 2T allerede meget stor. Hvis der er meget duplikeret indhold i den, svarer det til spild af værdifuld lagerplads. Når du rent faktisk bruger denne ordbogsfil til adgangskodeknækning eller andre operationer, kan duplikeret indhold resultere i unødvendige opsøgnings-og sammenligningsoperationer. For eksempel, hvis algoritmen under adgangskodeknækning skal sammenligne indholdet i ordbogen med måladgangskoden én efter én, vil det gentagne indhold øge antallet af sammenligninger og derved bremse hele cracking-processen.
2. Filtreringsmetode baseret på tekstbehandlingsværktøjer
Brug værktøjer under Windows-systemet
-Brug af PowerShell
-I Windows-systemer giver PowerShell rige tekstbehandlingsfunktioner. Vi kan bruge følgende PowerShell-script til at fjerne duplikerede linjer:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line i $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Dette script læser først alle linjerne i "dictionary.txt" ind i et array "$lines". Gennemgå derefter hver række gennem en sløjfe, og hvis en række ikke er i det nye array "$ uniqueLines", tilføj den til det nye array. Til sidst gem indholdet af det nye array til "unique_dictionary.txt".
Divide og erobre algoritme
-Da vores ordbogsfil er meget stor (2T), kan direkte behandling støde på problemer som utilstrækkelig hukommelse. Divide-and-conquer-algoritmen kan løse dette problem meget godt. Vi kan opdele denne store fil i flere mindre underfiler. For eksempel kan vi opdele det efter et bestemt antal linjer eller filstørrelse.
-Gentag derefter filtrering for hver underfil separat. Genfusioner de behandlede underfiler til én fil. Under fusionsprocessen skal du også kontrollere igen for duplikater, da det samme indhold kan eksistere mellem forskellige underfiler.
4. Bekræft filtreringsresultaterne
Efter at have fuldført gentagen filtrering, skal vi bekræfte, om resultaterne er korrekte. Du kan bruge nogle enkle metoder, såsom tilfældigt at trække nogle linjer og kontrollere antallet af forekomster af disse linjer i den oprindelige fil og den filtrerede fil. Hvis det vises flere gange i den oprindelige fil og kun en gang i den filtrerede fil, er filtreringen gyldig.
Derudover kan du sammenligne størrelsen på de originale og filtrerede filer. Hvis størrelsen af den filtrerede fil er væsentligt mindre end den originale fil, og den fungerer normalt i efterfølgende test (såsom at bruge denne ordbogsfil til en simpel adgangskodesøgningstest for at se, om den fungerer korrekt og ikke mangler den adgangskode, der skulle eksistere), kan det også indikere gentagelse Filtreringsarbejdet har opnået gode resultater.
Vores server bruger 512G hukommelse og en højhastigheds-NVMe-protokol-harddiskserver. Det tog en halv måned at fuldføre behandlingen med succes, og vi fandt ud af et sæt effektive behandlingsscripts, kan du kontakte hjemmesidens kundeservice for at kommunikere Filtrering af faldgruber, der er opstået under den gentagne proces, og skrivning af automatiske behandlingsscripts!
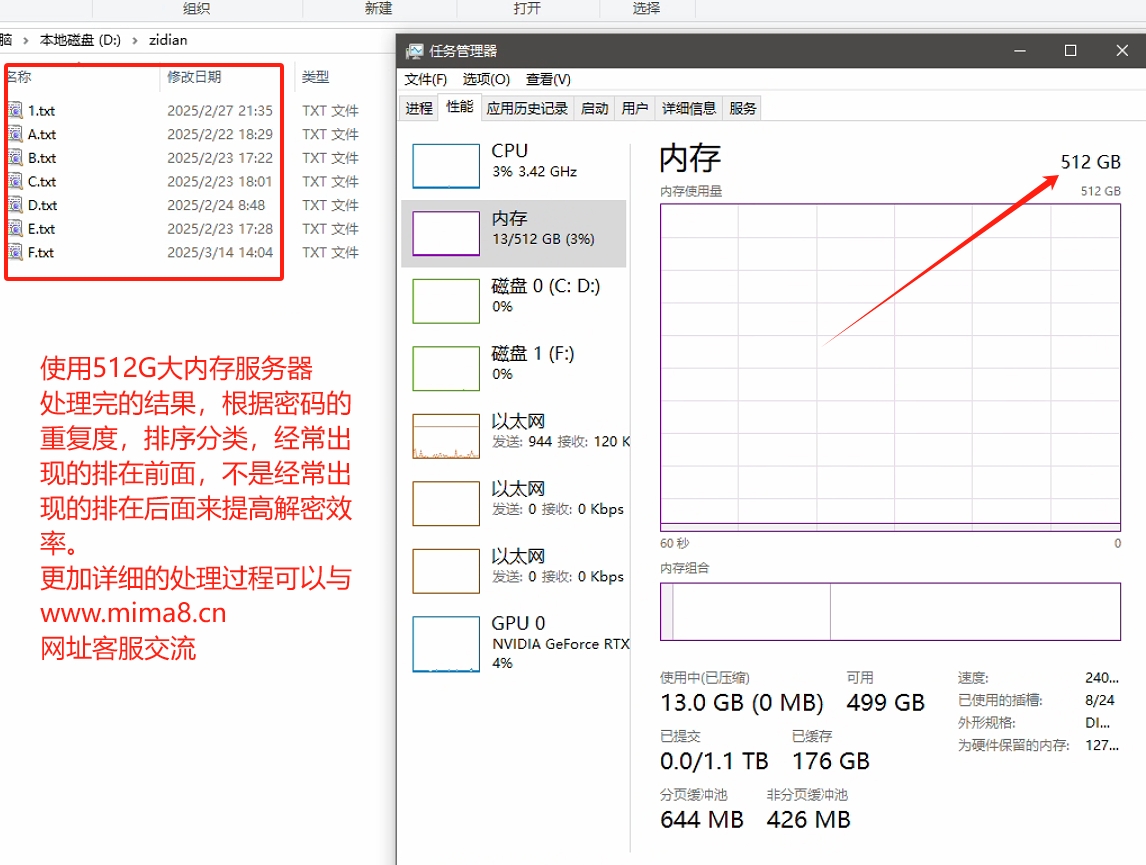
Det er en udfordrende, men meget nødvendig opgave at filtrere duplikater i 2T's teksttype ordbogsfiler. Ved at vælge værktøjer og algoritmer med rimelighed kan vi effektivt fjerne duplikeret indhold og forbedre kvaliteten og brugseffektiviteten af ordbogsfiler, hvilket er af stor betydning i både adgangskodeknækning og andre applikationsscenarier baseret på denne ordbogsfil.