 Mistr obnovy hesla dokumentu
Jak filtrovat duplicitní obsah ze slovníku 2T, filtrovat duplicitní obsah z extrémně velkého textu
V oblasti praskání hesel nebo zpracování dat je vlastnictví slovníkového souboru 2T textového typu velmi výkonným zdrojem. Takový obrovský soubor je však často náchylný k velkému množství duplicitních dat, což nejen zabere zbytečné úložné místo, ale může také ovlivnit efektivitu následných operací založených na tomto slovníkovém souboru, jako je rychlost vyhledávání hesel. Proto je efektivní filtrování duplicitního obsahu velmi kritickým krokem.
1. Pochopte zdroje a dopady duplicitních dat
Nejprve musíme pochopit, proč se generuje tolik duplicitních dat. Při vytváření slovníkového souboru mohou být data shromažďována z více zdrojů dat a mezi těmito zdroji dat dochází k částečnému překrývání. Například při shromažďování dat z různých seznamů slov, běžných sad hesel, různých seznamů kombinací znaků atd., Některá základní slova nebo jednoduché kombinace hesel mohou existovat ve více zdrojích.
Tyto duplicitní údaje mají mnoho nepříznivých účinků. Z hlediska úložiště je prostor 2T již velmi velký, pokud je v něm mnoho duplicitního obsahu, je to ekvivalentní plýtvání cenným úložným prostorem. Při skutečném použití tohoto slovníkového souboru pro prolomení hesla nebo jiné operace může duplicitní obsah způsobit zbytečné operace vyhledávání a porovnávání. Pokud například při crackingu hesla algoritmus potřebuje porovnat obsah ve slovníku s cílovým heslem jedno po druhém, duplicitní obsah zvýší počet srovnání, čímž zpomalí celý proces crackingu.
II. Metoda filtrování založená na nástrojích pro zpracování textu
Používejte nástroje v systému Windows
-Používejte PowerShell
-V systému Windows poskytuje PowerShell bohaté možnosti zpracování textu. K odstranění duplicitních řádků můžeme použít následující skript PowerShell:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Tento skript nejprve přečte všechny řádky v "dictionary.txt" do pole "$lines". Poté projděte každý řádek smyčkou a pokud řádek není v novém poli "$ uniqueLines", přidejte jej do nového pole. Nakonec uložte obsah nového pole do "unique_dictionary.txt".
Algoritmus rozdělení a dobývání
-Vzhledem k tomu, že naše slovníkové soubory jsou velmi velké (2T), přímé zpracování může narazit na problémy, jako je nedostatek paměti. Algoritmus rozdělení a dobývání může tento problém velmi dobře vyřešit. Tento velký soubor můžeme rozdělit na několik menších podsouborů. Můžeme jej například rozdělit podle určitého počtu řádků nebo velikosti souboru.
-Poté opakujte filtrování pro každý podsoubor samostatně. Znovu sloučte zpracované podsoubory do jednoho souboru. Během procesu sloučení je také třeba znovu zkontrolovat, zda neexistuje duplicitní obsah, protože stejný obsah může existovat mezi různými podsoubory.
4. Ověřte výsledky filtrování
Po dokončení opakovaného filtrování musíme ověřit, zda jsou výsledky správné. Můžete použít některé jednoduché metody, jako je náhodný výběr řádků, abyste zkontrolovali počet výskytů těchto řádků v původním souboru a filtrovaném souboru. Pokud se objeví vícekrát v původním souboru a pouze jednou ve filtrovaném souboru, znamená to, že filtrování je platné.
Alternativně můžete porovnat velikost původních a filtrovaných souborů. Pokud je velikost filtrovaného souboru výrazně menší než původní soubor a funguje normálně v následných testech (jako je použití tohoto slovníkového souboru k provedení jednoduchého testu vyhledávání hesla, abyste zjistili, zda funguje správně a zda nechybí heslo, které by mělo existovat), může to také znamenat, že opakovaná filtrační práce dosáhla dobrých výsledků.
Náš server používá 512G paměť a vysokorychlostní server s pevným diskem protokolu NVMe. Úspěšné zpracování trvalo půl měsíce a vynalezli jsme sadu efektivních skriptů pro zpracování. Pokud máte nějaké typové potřeby, můžete kontaktovat zákaznický servis webu pro komunikaci Filtrování úskalí, na které jste narazili během opakovaného procesu, a psaní skriptů pro automatické zpracování!
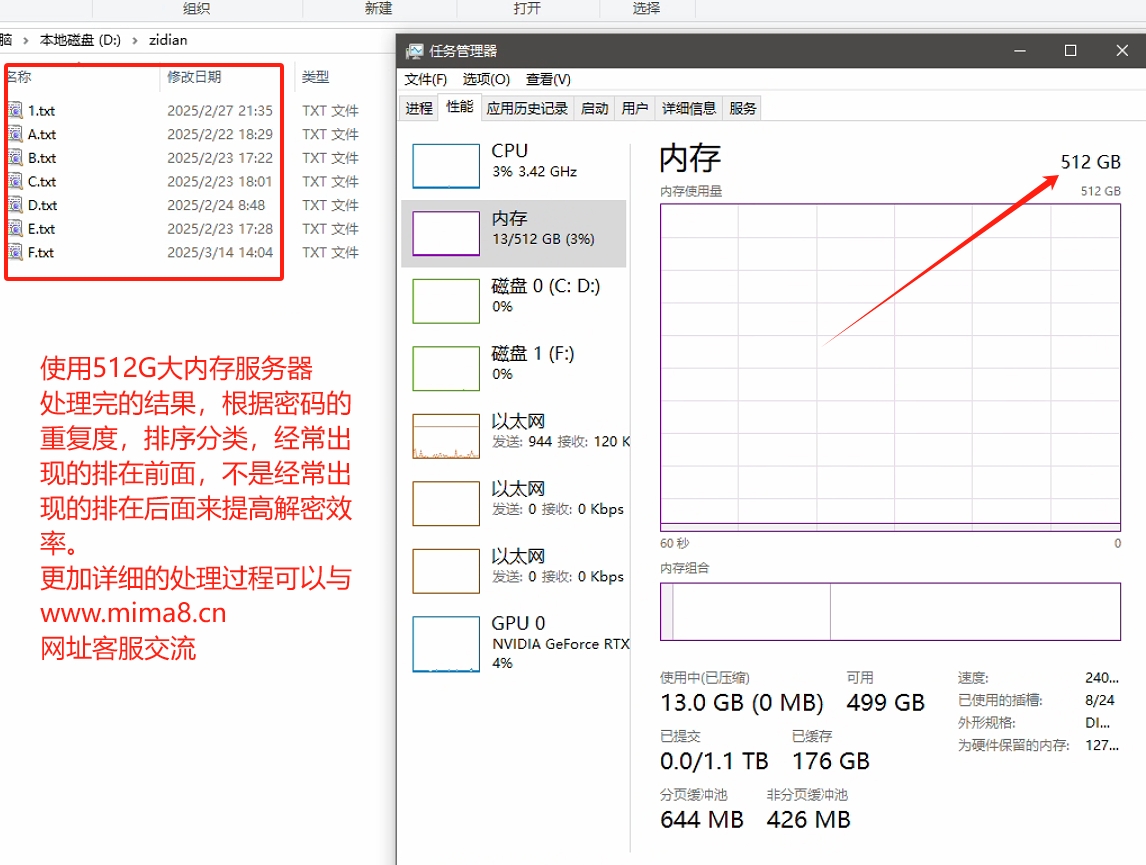
Filtrování duplicitního obsahu v 2T textových slovníkových souborech je náročná, ale velmi nezbytná práce. Přiměřeným výběrem nástrojů a algoritmů můžeme efektivně odstranit duplicitní obsah a zlepšit kvalitu a efektivitu používání slovníkových souborů, což má velký význam jak při praskání hesel, tak v jiných aplikačních scénářích založených na tomto slovníkovém souboru.