 กู้คืนรหัสผ่านเอกสาร Master
วิธีกรองเนื้อหาที่ซ้ำกันจากพจนานุกรม 2T, ข้อความขนาดใหญ่พิเศษกรองเนื้อหาที่ซ้ำกัน
ในด้านการถอดรหัสรหัสผ่านหรือการประมวลผลข้อมูล การมีไฟล์พจนานุกรมประเภทข้อความ 2T เป็นทรัพยากรที่มีประสิทธิภาพมาก อย่างไรก็ตาม ไฟล์ขนาดใหญ่ดังกล่าวมักจะมีแนวโน้มที่จะมีข้อมูลซ้ำจำนวนมาก ซึ่งไม่เพียงแต่ใช้พื้นที่จัดเก็บข้อมูลที่ไม่จำเป็นเท่านั้น แต่ยังอาจส่งผลต่อประสิทธิภาพการดำเนินการที่ตามมาตามไฟล์พจนานุกรมนี้ เช่น ความเร็วในการค้นหารหัสผ่าน ดังนั้นการกรองเนื้อหาที่ซ้ำกันอย่างมีประสิทธิภาพจึงเป็นขั้นตอนที่สำคัญ
1. ทำความเข้าใจแหล่งที่มาและผลกระทบของข้อมูลที่ซ้ำกัน
ก่อนอื่น เราต้องเข้าใจว่าทำไมข้อมูลที่ซ้ำกันจึงเกิดขึ้นมากมาย . ในระหว่างการสร้างไฟล์พจนานุกรมข้อมูลอาจถูกรวบรวมจากแหล่งข้อมูลหลายแหล่งและมีการทับซ้อนกันบางส่วนระหว่างแหล่งข้อมูลเหล่านี้ ตัวอย่างเช่นเมื่อรวบรวมข้อมูลจากรายการคำที่แตกต่างกันชุดรหัสผ่านทั่วไปรายการการรวมกันของอักขระต่าง ๆ ฯลฯ คำพื้นฐานบางคำหรือการรวมกันของรหัสผ่านอย่างง่ายอาจมีอยู่ในหลายแหล่ง
ข้อมูลที่ซ้ำกันเหล่านี้อาจส่งผลเสียมากมาย จากมุมมองของการจัดเก็บข้อมูลพื้นที่ 2T มีขนาดใหญ่มากอยู่แล้วหากมีเนื้อหาซ้ำ ๆ จำนวนมากก็เทียบเท่ากับการสิ้นเปลืองพื้นที่จัดเก็บข้อมูลอันมีค่า เมื่อใช้ไฟล์พจนานุกรมนี้สำหรับการถอดรหัสรหัสผ่านหรือการดำเนินการอื่น ๆ เนื้อหาที่ซ้ำกันอาจนำไปสู่การดำเนินการค้นหาและเปรียบเทียบที่ไม่จำเป็น ตัวอย่างเช่น หากในการถอดรหัสรหัสผ่าน อัลกอริธึมจำเป็นต้องเปรียบเทียบเนื้อหาในพจนานุกรมกับรหัสผ่านเป้าหมายทีละรายการ เนื้อหาที่ซ้ำกันจะเพิ่มจำนวนการเปรียบเทียบ ซึ่งจะทำให้กระบวนการถอดรหัสทั้งหมดช้าลง
2. วิธีการกรองตามเครื่องมือประมวลผลข้อความ
ใช้เครื่องมือ
{ ภายใต้ระบบ Windows} - ใช้ PowerShell
- ในระบบ Windows PowerShell มีฟังก์ชันการประมวลผลข้อความที่หลากหลาย เราสามารถใช้สคริปต์ PowerShell ต่อไปนี้เพื่อลบบรรทัดที่ซ้ำกัน:
```powershell
$lines = รับ - เนื้อหา "dictionary.txt"
$uniqueLines = @()
foreach ($line in $lines) {
if ($uniqueLines - ไม่มี $line) {
```
สคริปต์นี้เริ่มต้นด้วยการอ่านบรรทัดทั้งหมดใน "dictionary.txt" ลงในอาร์เรย์ "$lines" จากนั้นแต่ละแถวจะถูกสำรวจผ่านลูปและหากแถวไม่อยู่ในอาร์เรย์ใหม่ "$ uniqueLines" ให้เพิ่มลงในอาร์เรย์ใหม่ สุดท้าย บันทึกเนื้อหาในอาร์เรย์ใหม่ลงใน "unique_dictionary.txt"
อัลกอริทึมแบ่งและพิชิต
- เนื่องจากไฟล์พจนานุกรมของเรามีขนาดใหญ่มาก (2T) การประมวลผลโดยตรงอาจประสบปัญหาเช่นหน่วยความจำไม่เพียงพอ อัลกอริธึมแบ่งแยกและพิชิตสามารถแก้ปัญหานี้ได้เป็นอย่างดี เราสามารถแบ่งไฟล์ขนาดใหญ่นี้ออกเป็นไฟล์ย่อยขนาดเล็กหลายไฟล์ ตัวอย่างเช่นเราสามารถแบ่งตามจำนวนบรรทัดหรือขนาดไฟล์ที่แน่นอน
- จากนั้น แต่ละไฟล์ย่อยจะถูกกรองซ้ำแยกกัน รวมไฟล์ย่อยที่ประมวลผลใหม่เป็นไฟล์เดียว ในระหว่างกระบวนการรวม คุณต้องตรวจสอบอีกครั้งว่ามีเนื้อหาที่ซ้ำกันหรือไม่ เนื่องจากเนื้อหาเดียวกันอาจมีอยู่ระหว่างไฟล์ย่อยที่แตกต่างกัน
4. ตรวจสอบผลลัพธ์การกรอง
หลังจากเสร็จสิ้นการกรองซ้ำแล้ว เราต้องตรวจสอบว่าผลลัพธ์ถูกต้องหรือไม่ คุณสามารถใช้วิธีการง่ายๆ บางอย่าง เช่น สุ่มเลือกบรรทัดและตรวจสอบจำนวนครั้งที่บรรทัดเหล่านี้ปรากฏในไฟล์ต้นฉบับและไฟล์ที่กรอง หากปรากฏหลายครั้งในไฟล์ต้นฉบับและปรากฏเพียงครั้งเดียวในไฟล์ที่กรองการกรองนั้นถูกต้อง
นอกจากนี้ คุณยังสามารถเปรียบเทียบขนาดของไฟล์ต้นฉบับและไฟล์ที่กรองได้อีกด้วย หากขนาดไฟล์ที่กรองมีขนาดเล็กกว่าไฟล์ต้นฉบับอย่างมีนัยสำคัญ และทำงานได้ตามปกติในการทดสอบครั้งต่อๆ ไป (เช่น การใช้ไฟล์พจนานุกรมนี้เพื่อทำการทดสอบการค้นหารหัสผ่านอย่างง่ายเพื่อดูว่าทำงานได้อย่างถูกต้องหรือไม่และไม่พลาดรหัสผ่านที่ควรมีอยู่) ก็สามารถอธิบายได้เช่นกัน การทำซ้ำงานกรองได้ผลลัพธ์ที่ดี
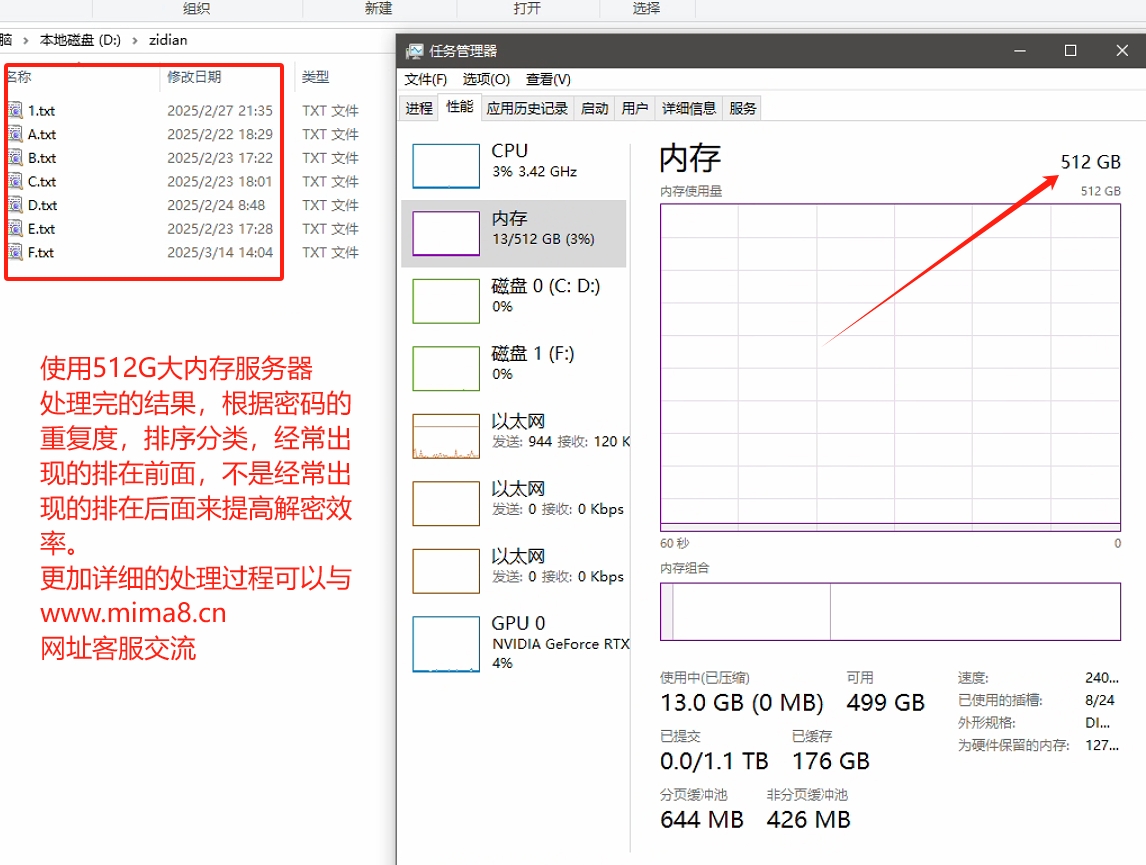
เซิร์ฟเวอร์ของเราใช้หน่วยความจำ 512G และเซิร์ฟเวอร์ฮาร์ดดิสก์โปรโตคอล NVMe ความเร็วสูง ใช้เวลาครึ่งเดือนในการประมวลผลสำเร็จและค้นพบชุดสคริปต์การประมวลผลที่มีประสิทธิภาพ หากคุณมีความต้องการประเภทใด ๆ คุณสามารถติดต่อได้ ฝ่ายบริการลูกค้าของเว็บไซต์เพื่อสื่อสารและกรองข้อผิดพลาดที่พบในระหว่างกระบวนการทำซ้ำและการเขียนสคริปต์การประมวลผลอัตโนมัติ!
การกรองเนื้อหาที่ซ้ำกันในไฟล์พจนานุกรมประเภทข้อความ 2T เป็นงานที่ท้าทาย แต่จำเป็นมาก ด้วยการเลือกเครื่องมือและอัลกอริธึมอย่างสมเหตุสมผล เราสามารถลบเนื้อหาที่ซ้ำกันได้อย่างมีประสิทธิภาพ และปรับปรุงคุณภาพและประสิทธิภาพการใช้งานของไฟล์พจนานุกรม ซึ่งมีความสำคัญอย่างยิ่งทั้งในการถอดรหัสรหัสผ่านและสถานการณ์การใช้งานอื่นๆ ที่ใช้ไฟล์พจนานุกรมนี้