 Recuperación de contraseña
Cómo filtrar el contenido duplicado del diccionario 2T, texto extra grande para filtrar el contenido duplicado
En el campo del descifrado de contraseñas o el procesamiento de datos, tener un archivo de diccionario de tipo texto 2T es un recurso bastante poderoso. Sin embargo, un archivo tan grande a menudo es propenso a una gran cantidad de datos duplicados, lo que no solo ocupa espacio de almacenamiento innecesario, sino que también puede afectar la eficiencia de las operaciones posteriores basadas en este archivo de diccionario, como la velocidad de búsqueda de contraseñas. Por lo tanto, filtrar efectivamente el contenido duplicado es un paso muy crítico.
1. Comprender la fuente y el impacto de los datos duplicados
Primero, debemos entender por qué se producen tantos datos duplicados. Durante la construcción de un archivo de diccionario, los datos pueden recopilarse de múltiples fuentes de datos, y hay una superposición parcial entre estas fuentes de datos. Por ejemplo, al recopilar datos de diferentes listas de palabras, conjuntos de contraseñas comunes, listas de varias combinaciones de caracteres, etc., algunas palabras básicas o combinaciones de contraseñas simples pueden existir en múltiples fuentes.
Estos datos duplicados tienen muchos efectos adversos. Desde el punto de vista del almacenamiento, el espacio de 2T ya es muy grande, si hay mucho contenido duplicado en él, equivale a desperdiciar un valioso espacio de almacenamiento. Al usar realmente este archivo de diccionario para descifrar contraseñas u otras operaciones, el contenido duplicado puede provocar operaciones de búsqueda y comparación innecesarias. Por ejemplo, si durante el descifrado de contraseñas, el algoritmo necesita comparar el contenido del diccionario con la contraseña de destino una por una, el contenido duplicado aumentará el número de comparaciones, ralentizando así todo el proceso de descifrado.
II. Método de filtrado basado en herramientas de procesamiento de texto
Utilice herramientas en el sistema Windows
-Utilice PowerShell
-En el sistema Windows, PowerShell proporciona ricas funciones de procesamiento de texto. Podemos usar el siguiente script de PowerShell para eliminar líneas duplicadas:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line en $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Este script primero lee todas las líneas en "dictionary.txt" en una matriz "$lines". Luego, recorra cada fila a través de un bucle, y si una fila no está en la nueva matriz "$uniqueLines", agreguela a esta nueva matriz. Finalmente, guarda el contenido de la nueva matriz en "unique_dictionary.txt".
Algoritmo de división y conquista
-Debido a que nuestro archivo de diccionario es muy grande (2T), el procesamiento directo puede experimentar problemas como memoria insuficiente. El algoritmo de dividir y conquistar puede resolver este problema muy bien. Podemos dividir este archivo grande en varios subarchivos más pequeños. Por ejemplo, podemos dividirlo según un cierto número de líneas o el tamaño del archivo.
-Luego, el filtrado se repite para cada subarchivo por separado. Refusionar los subarchivos procesados en un solo archivo. Durante el proceso de fusión, también es necesario comprobar nuevamente si hay contenido duplicado, ya que puede haber el mismo contenido entre diferentes subarchivos.
4. Verifique los resultados del filtrado
Después de completar el filtrado repetido, necesitamos verificar si los resultados son correctos. Puede utilizar algunos métodos simples, como extraer aleatoriamente algunas líneas y verificar el número de ocurrencias de estas líneas en el archivo original y el archivo filtrado. Si aparece varias veces en el archivo original y solo una vez en el archivo filtrado, significa que el filtrado es válido.
Además, es posible comparar el tamaño del archivo original y el filtrado. Si el tamaño del archivo filtrado es significativamente menor que el archivo original y funciona correctamente en pruebas posteriores (como usar este archivo de diccionario para realizar una simple prueba de búsqueda de contraseña para ver si funciona correctamente y no se pierde la contraseña que debería existir), también puede indicar que el trabajo de filtrado repetido ha logrado buenos resultados.
Nuestro servidor utiliza memoria de 512G y un servidor de disco duro con protocolo NVMe de alta velocidad. Tomó medio mes completar el procesamiento con éxito y descubrir un conjunto de scripts de procesamiento eficientes. Si tiene alguna necesidad, puede ponerse en contacto con el servicio de atención al cliente del sitio web para comunicarse. ¡Filtre las trampas encontradas durante el proceso de repetición y escriba scripts de procesamiento automático!
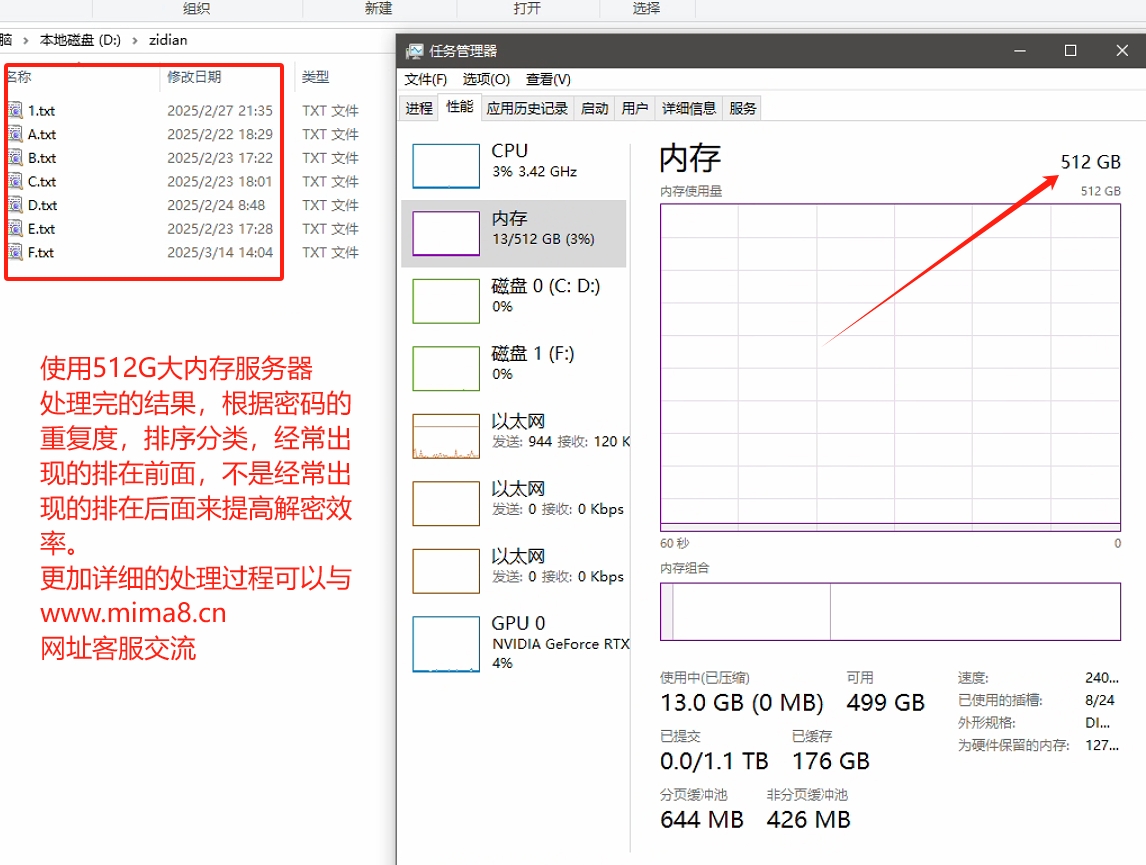
Filtrar el contenido duplicado en un archivo de diccionario de tipo de texto de 2T es un trabajo desafiante pero muy necesario. Al seleccionar razonablemente herramientas y algoritmos, podemos eliminar eficazmente el contenido duplicado y mejorar la calidad y la eficiencia del uso de los archivos de diccionario, lo que es de gran importancia tanto en el descifrado de contraseñas como en otros escenarios de aplicaciones basados en este archivo de diccionario.