 Bậc thầy khôi phục mật khẩu tài liệu
Cách lọc nội dung trùng lặp từ từ điển 2T, văn bản quá lớn lọc nội dung trùng lặp
Trong lĩnh vực bẻ khóa mật khẩu hoặc xử lý dữ liệu, việc có tệp từ điển kiểu văn bản 2T là một tài nguyên khá mạnh mẽ. Tuy nhiên, một tệp lớn như vậy thường dễ chứa một lượng lớn dữ liệu trùng lặp, điều này không chỉ chiếm dung lượng lưu trữ không cần thiết mà còn có thể ảnh hưởng đến hiệu quả của các hoạt động tiếp theo dựa trên tệp từ điển này, chẳng hạn như tốc độ tìm kiếm mật khẩu. Vì vậy, việc lọc nội dung trùng lặp một cách hiệu quả là một bước rất quan trọng.
1. Hiểu nguồn gốc và tác động của dữ liệu trùng lặp
Đầu tiên, chúng ta phải hiểu tại sao lại có rất nhiều dữ liệu trùng lặp. Trong quá trình xây dựng tệp từ điển, dữ liệu có thể được thu thập từ nhiều nguồn dữ liệu và có sự chồng chéo một phần giữa các nguồn dữ liệu này. Ví dụ, khi thu thập dữ liệu từ các danh sách từ khác nhau, bộ mật khẩu phổ biến, danh sách tổ hợp ký tự khác nhau, v.v., một số từ cơ bản hoặc tổ hợp mật khẩu đơn giản có thể tồn tại trong nhiều nguồn.
Những dữ liệu trùng lặp này sẽ mang lại nhiều tác động bất lợi. Từ góc độ lưu trữ, không gian của 2T đã rất lớn, nếu có nhiều nội dung trùng lặp trong đó thì tương đương với việc lãng phí không gian lưu trữ quý giá. Khi thực sự sử dụng tệp từ điển này để bẻ khóa mật khẩu hoặc các thao tác khác, nội dung trùng lặp sẽ dẫn đến các thao tác tìm kiếm và so sánh không cần thiết. Ví dụ, nếu trong quá trình bẻ khóa mật khẩu, thuật toán cần so sánh từng nội dung trong từ điển với mật khẩu đích thì nội dung trùng lặp sẽ làm tăng số lần so sánh, do đó làm chậm toàn bộ quá trình bẻ khóa.
2. Phương pháp lọc dựa trên các công cụ xử lý văn bản
Sử dụng các công cụ trong hệ thống Windows
-Sử dụng PowerShell
-Trong hệ thống Windows, PowerShell cung cấp khả năng xử lý văn bản phong phú. Chúng ta có thể sử dụng tập lệnh PowerShell sau để loại bỏ các hàng trùng lặp:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Tập lệnh này đầu tiên đọc tất cả các dòng trong "dictionary.txt" vào một mảng "$lines". Sau đó, mỗi hàng được lặp qua một vòng lặp và nếu một hàng không có trong mảng mới "$uniqueLines", nó được thêm vào mảng mới này. Cuối cùng, lưu nội dung trong mảng mới vào "unique_dictionary.txt".
Thuật toán chia và chinh phục
-Do tập tin từ điển của chúng tôi rất lớn (2T), xử lý trực tiếp có thể gặp phải các vấn đề như không đủ bộ nhớ. Thuật toán chia và chinh phục có thể giải quyết vấn đề này rất tốt. Chúng ta có thể chia tệp lớn này thành một số tệp con nhỏ hơn. Ví dụ, chúng ta có thể chia nó theo một số dòng hoặc kích thước tệp nhất định.
-Sau đó, lọc lặp lại từng tập tin con riêng biệt. Hợp nhất lại các tệp con đã được xử lý thành một tệp. Trong quá trình hợp nhất, bạn cũng cần kiểm tra lại xem có nội dung trùng lặp hay không, vì nội dung giống nhau có thể tồn tại giữa các file con khác nhau.
4. Xác minh kết quả lọc
Sau khi hoàn thành lọc lặp lại, chúng ta cần xác minh xem kết quả có đúng hay không. Bạn có thể sử dụng một số phương pháp đơn giản, chẳng hạn như rút ngẫu nhiên một số dòng và kiểm tra số lần các dòng này xuất hiện trong tệp gốc và tệp đã lọc. Nếu nó xuất hiện nhiều lần trong tệp gốc và chỉ xuất hiện một lần trong tệp được lọc, điều đó có nghĩa là việc lọc là hiệu quả.
Ngoài ra, bạn có thể so sánh kích thước của tệp gốc và tệp lọc. Nếu kích thước tệp được lọc nhỏ hơn đáng kể so với tệp gốc và hoạt động bình thường trong các thử nghiệm tiếp theo (chẳng hạn như sử dụng tệp từ điển này để thực hiện thử nghiệm tìm kiếm mật khẩu đơn giản để xem liệu nó có hoạt động bình thường hay không và không có mật khẩu nào bị bỏ sót), nó cũng có thể chỉ ra việc lặp lại Công việc lọc đã đạt được kết quả tốt.
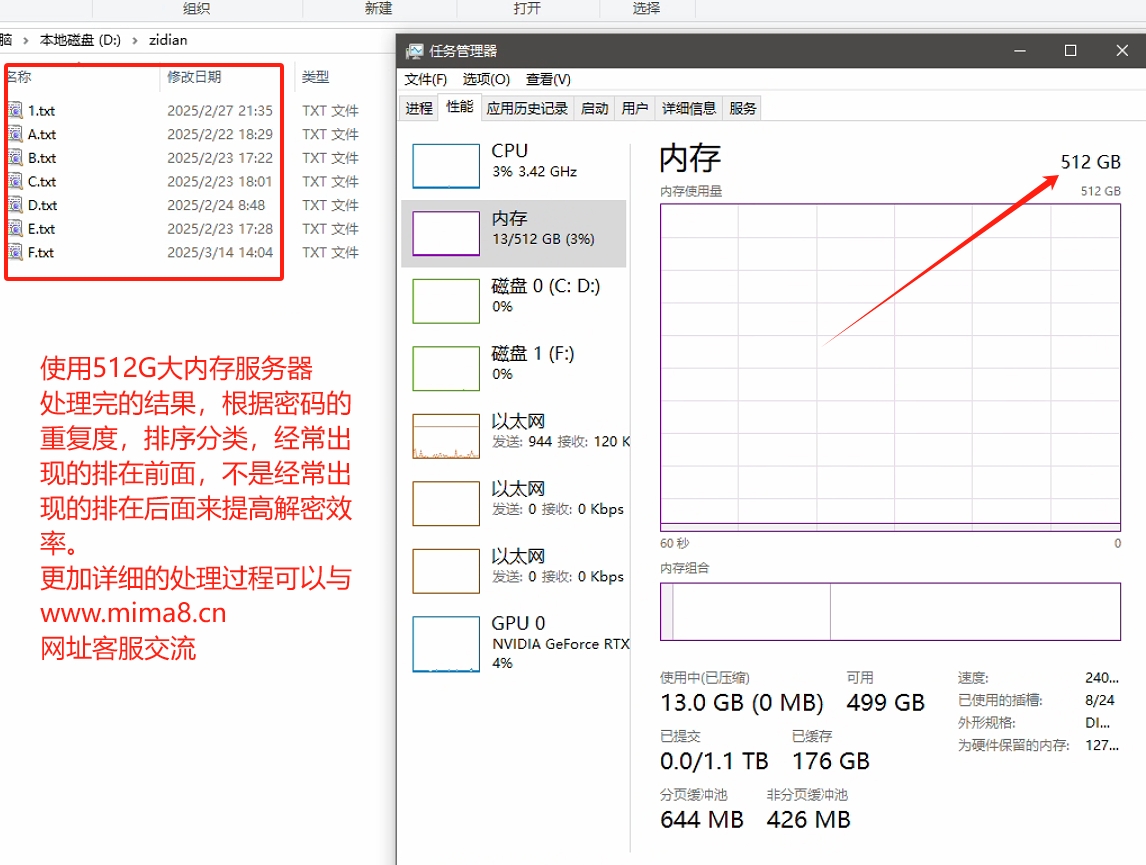
Máy chủ của chúng tôi sử dụng bộ nhớ 512G và máy chủ ổ cứng giao thức NVMe tốc độ cao. Phải mất nửa tháng để hoàn thành quá trình xử lý thành công và tìm ra một tập lệnh xử lý hiệu quả. Nếu bạn có bất kỳ nhu cầu nào, bạn có thể liên hệ với dịch vụ khách hàng của trang web để trao đổi. Lọc những cạm bẫy gặp phải trong quá trình lặp lại và viết các tập lệnh xử lý tự động!
Lọc nội dung trùng lặp trong tệp từ điển kiểu văn bản 2T là một công việc khó khăn nhưng rất cần thiết. Bằng cách lựa chọn các công cụ và thuật toán hợp lý, chúng ta có thể loại bỏ nội dung trùng lặp một cách hiệu quả và cải thiện chất lượng cũng như hiệu quả sử dụng các tệp từ điển, điều này có ý nghĩa to lớn trong việc bẻ khóa mật khẩu hoặc các kịch bản ứng dụng khác dựa trên tệp từ điển này.