 दस्तावेज़ पासवर्ड रिकवरी मास्टर
2T शब्दकोश से डुप्लिकेट फ़िल्टर कैसे करें, अतिरिक्त बड़े पाठ से डुप्लिकेट फ़िल्टर करें
पासवर्ड क्रैकिंग या डेटा प्रोसेसिंग के क्षेत्र में, 2T टेक्स्ट टाइप डिक्शनरी फ़ाइल होना एक काफी शक्तिशाली संसाधन है । हालाँकि, इतनी बड़ी फ़ाइल अक्सर बड़ी मात्रा में डुप्लिकेट डेटा से ग्रस्त होती है, जो न केवल अनावश्यक भंडारण स्थान लेती है, बल्कि इस शब्दकोश फ़ाइल के आधार पर बाद के संचालन की दक्षता को भी प्रभावित कर सकती है, जैसे पासवर्ड खोज की गति । इसलिए, डुप्लिकेट सामग्री को प्रभावी ढंग से फ़िल्टर करना एक बहुत ही महत्वपूर्ण कदम है ।
1. डुप्लिकेट डेटा के स्रोत और प्रभाव को समझना
सबसे पहले, हमें यह समझना होगा कि इतने सारे डुप्लिकेट डेटा क्यों उत्पन्न होते हैं । एक शब्दकोश फ़ाइल के निर्माण के दौरान, कई डेटा स्रोतों से डेटा एकत्र किया जा सकता है, और इन डेटा स्रोतों के बीच आंशिक ओवरलैप है । उदाहरण के लिए, विभिन्न शब्द सूचियों, सामान्य पासवर्ड सेटों, विभिन्न वर्ण संयोजन सूचियों आदि से डेटा एकत्र करते समय, कुछ बुनियादी शब्द या सरल पासवर्ड संयोजन कई स्रोतों में मौजूद हो सकते हैं ।
इन डुप्लिकेट डेटा के कई प्रतिकूल प्रभाव होंगे । भंडारण के दृष्टिकोण से, 2T का स्थान पहले से ही बहुत बड़ा है । यदि इसमें बहुत सारी डुप्लिकेट सामग्री है, तो यह मूल्यवान भंडारण स्थान को बर्बाद करने के बराबर है । जब आप वास्तव में पासवर्ड क्रैकिंग या अन्य संचालन के लिए इस शब्दकोश फ़ाइल का उपयोग करते हैं, तो डुप्लिकेट सामग्री अनावश्यक खोज और तुलना संचालन का कारण बनेगी । उदाहरण के लिए, यदि पासवर्ड क्रैकिंग में, एल्गोरिदम को शब्दकोश में सामग्री की तुलना लक्ष्य पासवर्ड के साथ एक-एक करके करने की आवश्यकता होती है, तो दोहराई गई सामग्री तुलनाओं की संख्या बढ़ा देगी, जिससे पूरी क्रैकिंग प्रक्रिया धीमी हो जाएगी ।
2. टेक्स्ट प्रोसेसिंग टूल पर आधारित फ़िल्टरिंग विधि
विंडोज सिस्टम के तहत टूल का उपयोग करें
- PowerShell का उपयोग करें
- विंडोज सिस्टम में, PowerShell समृद्ध टेक्स्ट प्रोसेसिंग क्षमताएं प्रदान करता है । हम डुप्लिकेट लाइनों को हटाने के लिए निम्नलिखित PowerShell स्क्रिप्ट का उपयोग कर सकते हैं:
```powershell
$lines = प्राप्त करें - सामग्री "dictionary.txt"
$uniqueLines = @()
foreach ($lines में $line) {
if ($uniqueLines - $line नहीं है) {
```
यह स्क्रिप्ट पहले "dictionary.txt" में सभी पंक्तियों को एक सरणी "$lines" में पढ़ती है । फिर, प्रत्येक पंक्ति को एक लूप के माध्यम से पार किया जाता है, और यदि कोई पंक्ति नई सरणी "$ uniqueLines" में नहीं है, तो इसे इस नई सरणी में जोड़ा जाता है । अंत में, नई सरणी की सामग्री को "unique_dictionary.txt" में सहेजें ।
विभाजन और विजय एल्गोरिथ्म
- चूंकि हमारी शब्दकोश फ़ाइलें बहुत बड़ी (2T) हैं, इसलिए सीधे प्रसंस्करण में अपर्याप्त मेमोरी जैसी समस्याओं का सामना करना पड़ सकता है । विभाजन और विजय एल्गोरिथ्म इस समस्या को अच्छी तरह से हल कर सकता है । हम इस बड़ी फ़ाइल को कई छोटी उप-फ़ाइलों में विभाजित कर सकते हैं । उदाहरण के लिए, हम इसे एक निश्चित संख्या में पंक्तियों या फ़ाइल आकार के अनुसार विभाजित कर सकते हैं ।
- फिर, प्रत्येक उप-फ़ाइल को अलग से दोहराया जाता है । संसाधित उपफ़ाइलों को एक फ़ाइल में फिर से मर्ज करें । विलय प्रक्रिया के दौरान, आपको डुप्लिकेट सामग्री के लिए फिर से जांचने की आवश्यकता है, क्योंकि विभिन्न उपफ़ाइलों के बीच समान सामग्री मौजूद हो सकती है ।
4. फ़िल्टरिंग परिणाम सत्यापित करें
बार-बार फ़िल्टरिंग पूरी करने के बाद, हमें यह सत्यापित करने की आवश्यकता है कि परिणाम सही हैं या नहीं । आप कुछ सरल तरीकों का उपयोग कर सकते हैं, जैसे कि बेतरतीब ढंग से पंक्तियाँ निकालना और मूल फ़ाइल और फ़िल्टर की गई फ़ाइल में इन पंक्तियों की घटनाओं की संख्या की जांच करना । यदि यह मूल फ़ाइल में कई बार दिखाई देता है और फ़िल्टर की गई फ़ाइल में केवल एक बार दिखाई देता है, तो फ़िल्टरिंग मान्य है ।
इसके अलावा, आप मूल फ़ाइल और फ़िल्टर की गई फ़ाइल के आकार की तुलना कर सकते हैं । यदि फ़िल्टर की गई फ़ाइल का आकार मूल फ़ाइल की तुलना में काफी छोटा है, और बाद के परीक्षणों में सामान्य प्रदर्शन करता है (जैसे कि यह देखने के लिए कि क्या यह ठीक से काम कर सकता है और मौजूद पासवर्ड को छूटे बिना एक साधारण पासवर्ड खोज परीक्षण करने के लिए इस शब्दकोश फ़ाइल का उपयोग करना), इसका मतलब यह भी हो सकता है कि बार-बार फ़िल्टरिंग कार्य ने अच्छे परिणाम प्राप्त किए हैं ।
हमारा सर्वर 512G मेमोरी और एक हाई-स्पीड एनवीएमई प्रोटोकॉल हार्ड डिस्क सर्वर का उपयोग करता है । प्रसंस्करण को सफलतापूर्वक पूरा करने और कुशल प्रसंस्करण स्क्रिप्ट का एक सेट खोजने में आधा महीना लगा । यदि आपको किसी प्रकार की आवश्यकता है, तो आप संचार के लिए वेबसाइट ग्राहक सेवा से संपर्क कर सकते हैं और फ़िल्टर कर सकते हैं । दोहराव प्रक्रिया के दौरान सामने आई खामियाँ, साथ ही स्वचालित प्रसंस्करण स्क्रिप्ट लिखना!
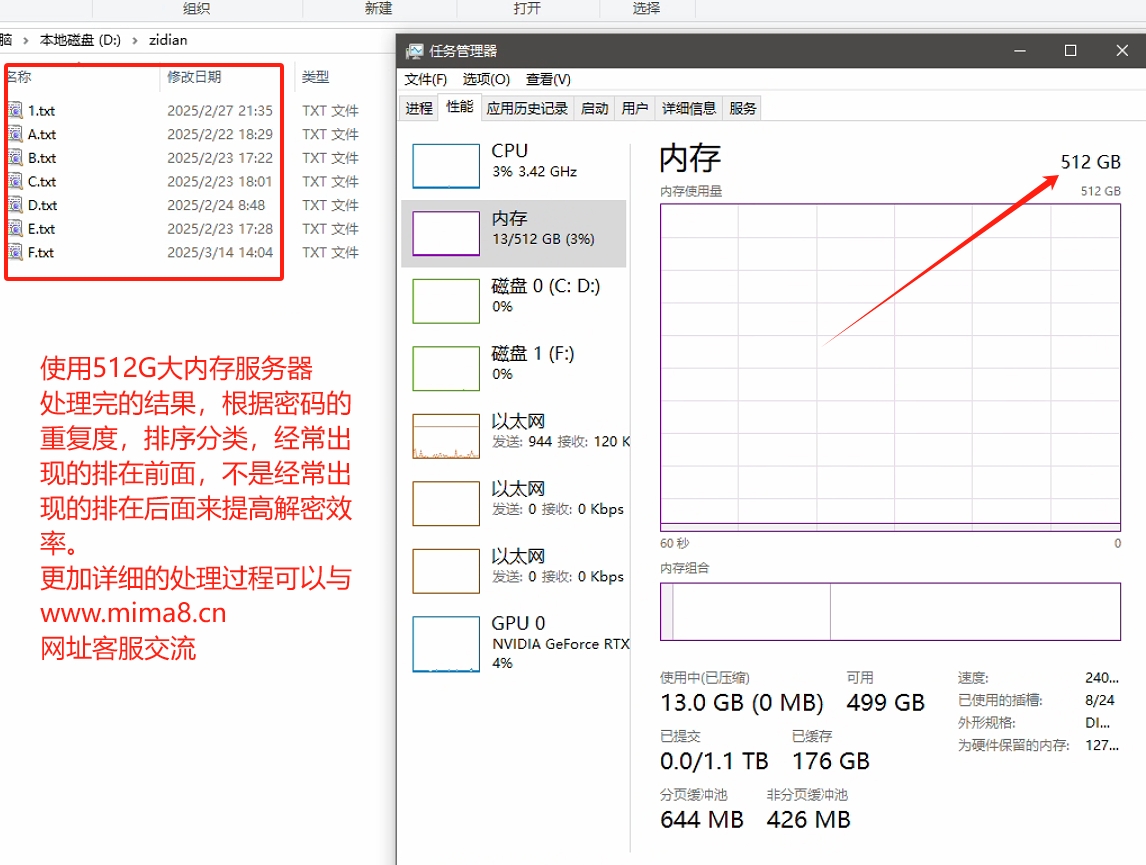
फ़िल्टर करने के लिए 2T पाठ प्रकार शब्दकोश फ़ाइलों में डुप्लिकेट एक चुनौतीपूर्ण लेकिन बहुत आवश्यक कार्य है । उचित रूप से उपकरणों और एल्गोरिदम का चयन करके, हम डुप्लिकेट सामग्री को प्रभावी ढंग से हटा सकते हैं और शब्दकोश फ़ाइलों की गुणवत्ता और उपयोग दक्षता में सुधार कर सकते हैं, जो इस शब्दकोश फ़ाइल पर आधारित पासवर्ड क्रैकिंग और अन्य एप्लिकेशन परिदृश्यों में बहुत महत्वपूर्ण है ।