 Dokumen Password Recovery Master
Cara menyaring duplikat dari kamus 2T, teks besar menyaring duplikat
Di bidang pemecahan kata sandi atau pemrosesan data, memiliki file kamus tipe teks 2T adalah sumber daya yang cukup kuat. Namun, file yang begitu besar seringkali rentan terhadap data duplikat dalam jumlah besar, yang tidak hanya akan memakan ruang penyimpanan yang tidak perlu, tetapi juga dapat mempengaruhi efisiensi operasi selanjutnya berdasarkan file kamus ini, seperti kecepatan pencarian kata sandi. Oleh karena itu, menyaring konten duplikat secara efektif merupakan langkah yang sangat penting.
1. Memahami sumber dan dampak data duplikat
Pertama, kita harus memahami mengapa banyak data duplikat dihasilkan. Selama proses pembuatan file kamus, data dapat dikumpulkan dari beberapa sumber data, dan ada tumpang tindih parsial di antara sumber data ini sendiri. Misalnya, ketika mengumpulkan data dari daftar kata yang berbeda, kumpulan kata sandi umum, daftar berbagai kombinasi karakter, dll., Beberapa kata dasar atau kombinasi kata sandi sederhana mungkin ada di beberapa sumber.
Data duplikat ini memiliki banyak efek merugikan. Dari sudut pandang penyimpanan, ruang 2T sudah sangat besar, dan jika terdapat banyak konten duplikat di dalamnya, itu setara dengan pemborosan ruang penyimpanan yang berharga. Saat benar-benar menggunakan file kamus ini untuk pemecahan kata sandi atau operasi lainnya, konten duplikat dapat menyebabkan operasi pencarian dan perbandingan yang tidak perlu. Misalnya, jika dalam pemecahan kata sandi, algoritma perlu membandingkan konten dalam kamus dengan kata sandi target satu per satu, konten yang berulang akan meningkatkan jumlah perbandingan, sehingga memperlambat seluruh proses pemecahan.
2. Metode pemfilteran berdasarkan alat pemrosesan teks
Gunakan alat di bawah sistem Windows
-Gunakan PowerShell
-Dalam sistem Windows, PowerShell menyediakan kemampuan pemrosesan teks yang kaya. Kita dapat menggunakan skrip PowerShell berikut untuk menghilangkan baris duplikat:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Skrip ini terlebih dahulu membaca semua baris di "dictionary.txt" ke dalam array "$lines". Kemudian, melalui loop melalui setiap baris, jika baris tidak ada di array baru "$uniqueLines", tambahkan ke array baru ini. Terakhir, simpan isi dari array baru ke "unique_dictionary.txt".
Divide and Conquer Algorithm
-Karena file kamus kami sangat besar (2T), pemrosesan langsung mungkin mengalami masalah seperti memori yang tidak mencukupi. Algoritma dibagi dan menaklukkan dapat memecahkan masalah ini dengan baik. Kita dapat membagi file besar ini menjadi beberapa subfile yang lebih kecil. Misalnya, kita dapat membaginya sesuai dengan jumlah baris atau ukuran file tertentu.
-Kemudian, penyaringan berulang dilakukan untuk setiap subfile secara terpisah. Menggabungkan kembali subfile yang diproses menjadi satu file. Selama proses penggabungan, Anda juga perlu memeriksa lagi apakah ada duplikat, karena konten yang sama mungkin ada di antara subfile yang berbeda.
4. Verifikasi hasil penyaringan
Setelah menyelesaikan penyaringan berulang, kita perlu memverifikasi apakah hasilnya benar. Anda dapat menggunakan beberapa metode sederhana, seperti mengambil baris secara acak dan memeriksa berapa kali baris ini muncul dalam file asli dan file yang disaring. Jika muncul beberapa kali di file asli dan hanya sekali di file yang difilter, pemfilteran itu efektif.
Selain itu, Anda juga dapat membandingkan ukuran file asli dan file yang difilter. Jika ukuran file yang difilter secara signifikan lebih kecil dari file aslinya, dan berkinerja normal dalam pengujian selanjutnya (seperti menggunakan file kamus ini untuk tes pencarian kata sandi sederhana untuk melihat apakah itu berfungsi dengan baik dan tidak ada kata sandi yang terlewatkan), itu juga dapat menunjukkan bahwa pekerjaan penyaringan berulang telah mencapai hasil yang lebih baik.
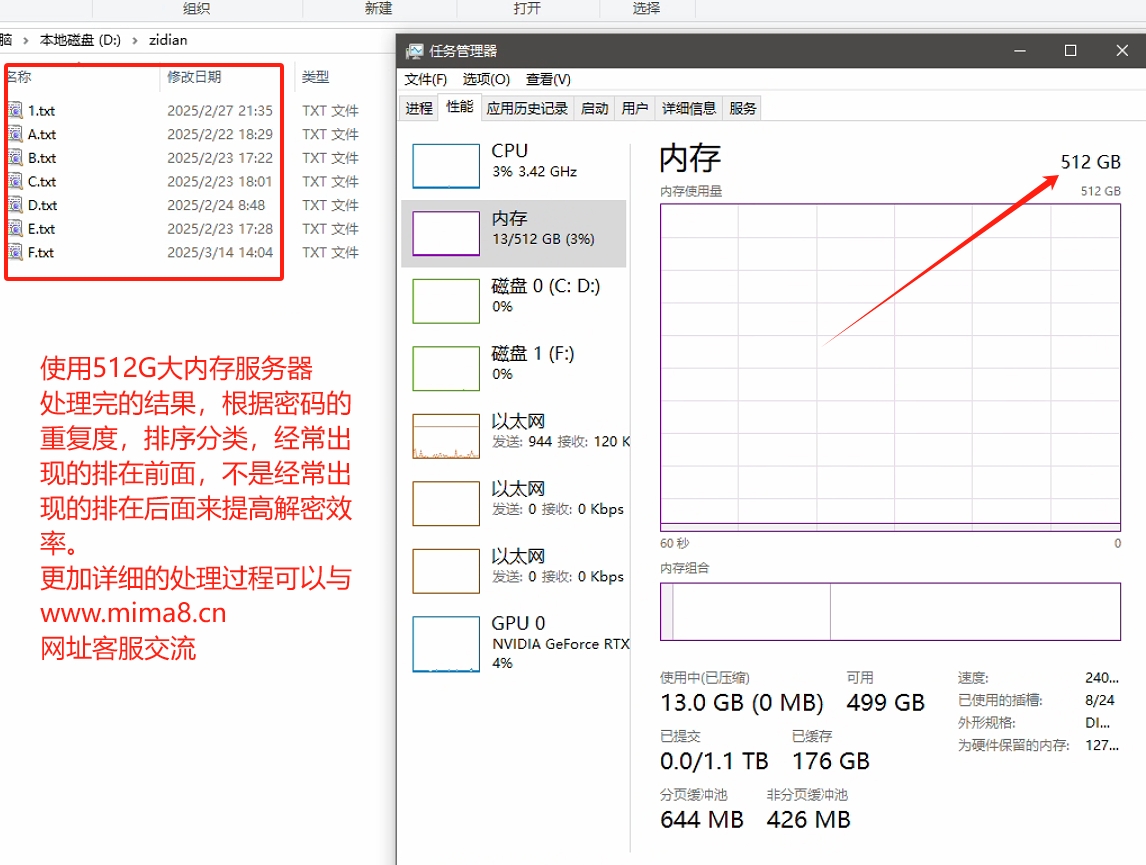
Server kami menggunakan memori 512G dan server hard disk protokol NVMe berkecepatan tinggi. Butuh waktu setengah bulan untuk berhasil menyelesaikan pemrosesan dan menemukan serangkaian skrip pemrosesan yang efisien. Jika Anda memiliki kebutuhan tipe, Anda dapat menghubungi layanan pelanggan situs web untuk berkomunikasi dan menyaring jebakan yang ditempuh selama proses pengulangan, serta menulis skrip pemrosesan otomatis!
Menyaring konten duplikat dalam file kamus tipe teks 2T adalah pekerjaan yang menantang namun sangat diperlukan. Dengan memilih alat dan algoritma secara wajar, kita dapat secara efektif menghilangkan konten duplikat dan meningkatkan kualitas serta efisiensi penggunaan file kamus, yang sangat penting baik dalam pemecahan kata sandi maupun skenario aplikasi lain berdasarkan file kamus ini.