 Dokument lösenord återställning master
Hur man filtrerar duplicerat innehåll från 2T ordbok, extra stor text filtrerar duplicerat innehåll
Inom området lösenordsknäckning eller databehandling är det en mycket kraftfull resurs att ha en 2T-ordboksfil av texttyp. En så stor fil är dock ofta benägen att innehålla en stor mängd dubbel data, vilket inte bara tar upp onödigt lagringsutrymme, utan kan också påverka effektiviteten i efterföljande operationer baserade på denna ordboksfil, såsom hastigheten för lösenordssökning. Därför är det ett mycket kritiskt steg att effektivt filtrera dubbelt innehåll.
1. Förstå källan och effekterna av dubbla data
Först måste vi förstå varför så många dubbla data produceras. Under byggandet av en ordboksfil kan data samlas in från flera datakällor, och det finns delvis överlappning mellan dessa datakällor. Till exempel, när du samlar in data från olika ordlistor, vanliga lösenordsuppsättningar, olika teckenkombinationslistor etc., kan vissa grundläggande ord eller enkla lösenordskombinationer finnas i flera källor.
Dessa duplicerade data kommer att medföra många negativa effekter. Ur lagringsperspektiv är utrymmet i 2T redan mycket stort. Om det finns mycket dubbelt innehåll i det motsvarar det slöseri med värdefullt lagringsutrymme. När du faktiskt använder den här ordboksfilen för lösenordsbrytning eller andra operationer, kan dubbelt innehåll leda till onödiga sök-och jämförelseoperationer. Till exempel, om algoritmen behöver jämföra innehållet i ordboken med mållösenordet en efter en under lösenordskrackning, kommer det upprepade innehållet att öka antalet jämförelser, vilket saktar ner hela knäckningsprocessen.
2. Filtreringsmetod baserad på textbehandlingsverktyg
Använd verktyg under Windows-system
-Använd PowerShell
-I Windows-system tillhandahåller PowerShell rika textbehandlingsfunktioner. Vi kan använda följande PowerShell-skript för att ta bort dubbla rader:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line i $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Detta skript läser först alla rader i "dictionary.txt" till en array "$lines". Gå sedan igenom varje rad genom en slinga, och om en rad inte finns i den nya arrayen "$ uniqueLines", lägg till den i den nya arrayen. Slutligen spara innehållet i den nya arrayen till "unique_dictionary.txt".
Dela och erövra algoritmen
-Eftersom våra ordboksfiler är väldigt stora (2T) kan direkt bearbetning stöta på problem som otillräckligt minne. Dela och erövra algoritmen kan lösa detta problem mycket bra. Vi kan dela upp denna stora fil i flera mindre underfiler. Till exempel kan vi dela upp det enligt ett visst antal rader eller filstorlek.
-Upprepa sedan filtreringen för varje underfil separat. Återslå de bearbetade underfilerna till en fil. Under sammanslagningsprocessen måste du också kontrollera om det finns dubbel innehåll igen, eftersom det kan finnas samma innehåll mellan olika underfiler.
4. Verifiera filtreringsresultaten
Efter att ha slutfört den upprepade filtreringen måste vi verifiera att resultaten är korrekta. Du kan använda några enkla metoder, som att slumpmässigt plocka rader för att kontrollera antalet förekomster av dessa rader i den ursprungliga filen och den filtrerade filen. Om det visas flera gånger i den ursprungliga filen och endast en gång i den filtrerade filen är filtreringen giltig.
Alternativt är det möjligt att jämföra storleken på den ursprungliga filen och den filtrerade filen. Om den filtrerade filstorleken är betydligt mindre än den ursprungliga filen och fungerar normalt i efterföljande tester (som att använda den här ordboksfilen för att utföra ett enkelt lösenordssökningstest för att se om den fungerar korrekt och inte saknar lösenordet som borde finnas), kan det också indikera upprepning Filtreringsarbetet har uppnått goda resultat.
Vår server använder 512G-minne och en höghastighets NVMe-protokollhårddiskserver. Det tog en halv månad att framgångsrikt slutföra bearbetningen och utforska en uppsättning effektiva bearbetningsskript webbplatsens kundtjänst för att kommunicera Filtrera fallgropar som uppstått under upprepningsprocessen och skriva automatiska bearbetningsskript!
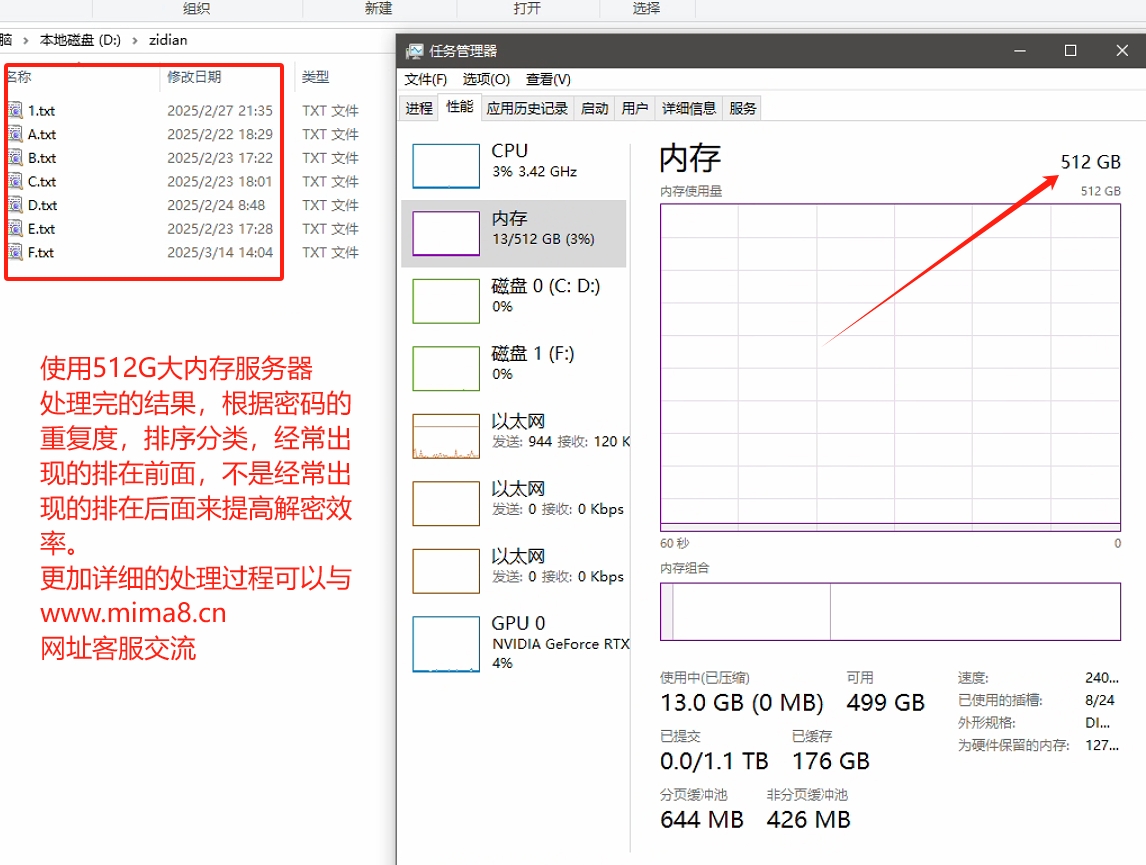
Att filtrera duplicerat innehåll i 2T:s ordboksfiler av texttyp är ett utmanande men mycket nödvändigt arbete. Genom att välja verktyg och algoritmer på ett rimligt sätt kan vi effektivt ta bort dubbelt innehåll och förbättra kvaliteten och användningseffektiviteten hos ordboksfiler, vilket är av stor betydelse både vid lösenordsknäckning och andra applikationsscenarier baserade på denna ordboksfil.