 Maître de récupération de mot de passe de document
Comment filtrer les duplicats à partir du dictionnaire 2T, filtrer les duplicats de texte surdimensionné
Dans le domaine du craquage de mots de passe ou du traitement des données, posséder un fichier dictionnaire de type texte 2T est une ressource assez puissante. Cependant, un fichier aussi énorme est souvent sujet à une grande quantité de données dupliquées, ce qui non seulement occupe un espace de stockage inutile, mais peut également affecter l'efficacité des opérations ultérieures basées sur ce fichier de dictionnaire, telles que la vitesse de recherche de mot de passe. Par conséquent, filtrer efficacement le contenu dupliqué est une étape très critique.
1. Comprendre les sources et les effets des données dupliquées
Tout d'abord, nous devons comprendre pourquoi autant de données dupliquées sont générées. Lors de la construction d'un fichier dictionnaire, les données peuvent être collectées à partir de plusieurs sources de données, et ces sources de données se chevauchent partiellement. Par exemple, lors de la collecte de données à partir de différentes listes de mots, d'ensembles de mots de passe courants, de listes de diverses combinaisons de caractères, etc., certains mots de base ou combinaisons de mots de passe simples peuvent exister dans plusieurs sources.
Ces données dupliquées peuvent avoir de nombreux effets néfastes. Du point de vue du stockage, l'espace de 2T est déjà très énorme. S'il y a beaucoup de contenu en double, cela équivaut à un gaspillage d'espace de stockage précieux. Lors de l'utilisation réelle de ce fichier de dictionnaire pour le craquage de mots de passe ou d'autres opérations, le contenu en double entraînera des opérations de recherche et de comparaison inutiles. Par exemple, si lors du craquage de mot de passe, l'algorithme doit comparer le contenu du dictionnaire avec le mot de passe cible un par un, le contenu en double augmentera le nombre de comparaisons, ralentissant ainsi l'ensemble du processus de craquage.
II. Méthode de filtrage basée sur les outils de traitement de texte
Utilisez les outils sous le système Windows
-Utilisez PowerShell
-Dans le système Windows, PowerShell fournit de riches fonctions de traitement de texte. Nous pouvons utiliser le script PowerShell suivant pour supprimer les lignes dupliquées:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Ce script lit d'abord toutes les lignes de "dictionary.txt" dans un tableau "$lines". Ensuite, chaque ligne est parcourue par une boucle et si une ligne n'est pas dans le nouveau tableau "$uniqueLines", elle est ajoutée à ce nouveau tableau. Enfin, enregistrez le contenu du nouveau tableau dans "unique_dictionary.txt".
Algorithme de division et de conquête
-Comme notre fichier de dictionnaire est très grand (2T), le traitement direct peut rencontrer des problèmes tels que manque de mémoire. L'algorithme de division et de conquête peut bien résoudre ce problème. Nous pouvons diviser ce grand fichier en plusieurs petits sous-fichiers. Par exemple, nous pouvons le diviser en fonction d'un certain nombre de lignes ou de la taille du fichier.
-Ensuite, répétez le filtrage séparément pour chaque sous-fichier. Fusionnez les sous-fichiers traités en un seul fichier. Pendant le processus de fusion, il est également nécessaire de vérifier à nouveau s'il y a un contenu dupliqué, car le même contenu peut exister entre différents sous-fichiers.
4. Vérifier les résultats du filtrage
Après avoir terminé le filtrage répété, nous devons vérifier si les résultats sont corrects. Vous pouvez utiliser des méthodes simples, telles que sélectionner aléatoirement des lignes et vérifier le nombre d'occurrences de ces lignes dans le fichier original et le fichier filtré. S'il apparaît plusieurs fois dans le fichier original et seulement une fois dans le fichier filtré, le filtrage est efficace.
De plus, vous pouvez comparer la taille du fichier original et du fichier filtré. Si la taille du fichier filtré est nettement plus petite que celle du fichier d'origine et fonctionne correctement dans les tests ultérieurs (tels que l'utilisation de ce fichier de dictionnaire pour effectuer un simple test de recherche de mot de passe pour voir si il fonctionne correctement et que le mot de passe qui devrait exister n'est pas manqué), cela peut également indiquer que le travail de filtrage répété a obtenu de bons résultats.
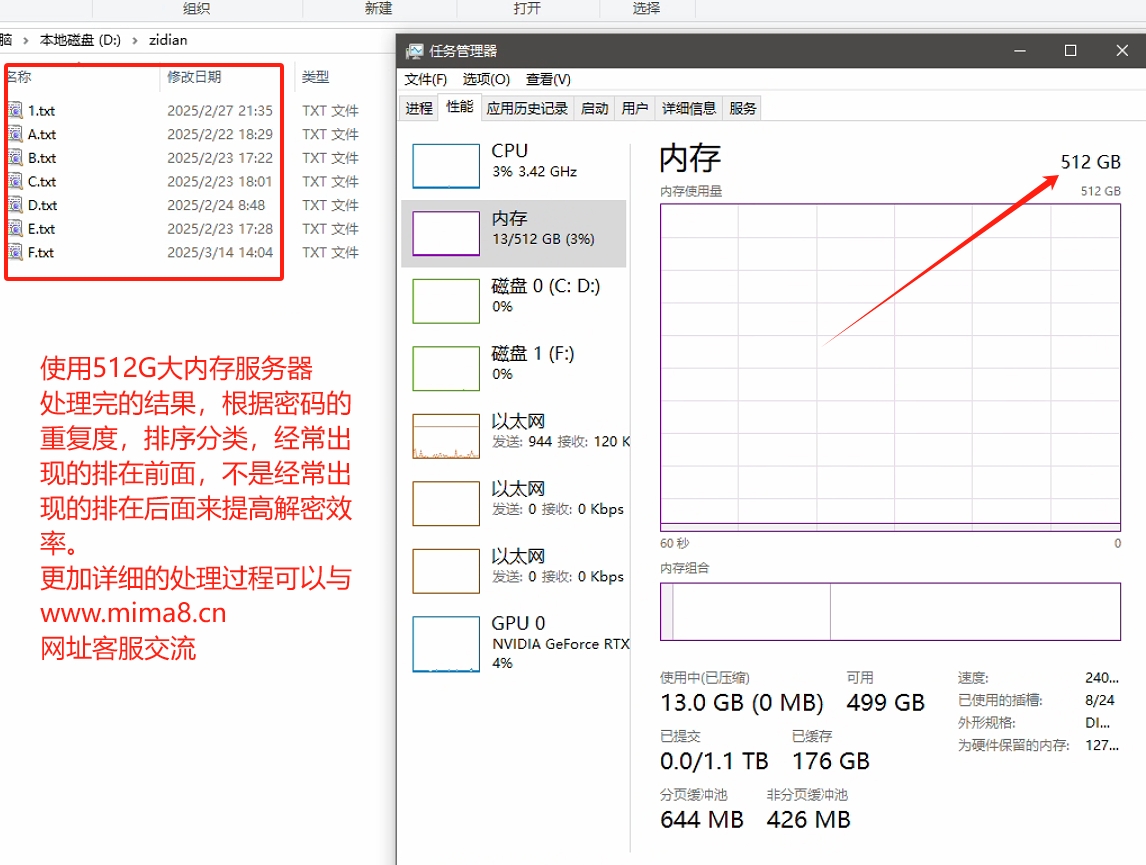
Notre serveur utilise une mémoire de 512 G et un serveur de disque dur au protocole NVMe à grande vitesse. Il a fallu un demi-mois pour terminer le traitement avec succès et trouver un ensemble de scripts de traitement efficaces. Si vous avez des besoins de type, vous pouvez contacter le service client du site Web pour communiquer et filtrer les pièges rencontrés lors du processus de répétition, ainsi que l'écriture de scripts de traitement automatique!
Filtrer les duplicats dans les fichiers de dictionnaire de type de texte de 2T est un travail difficile mais très nécessaire. En sélectionnant raisonnablement des outils et des algorithmes, nous pouvons éliminer efficacement le contenu en double et améliorer la qualité et l'efficacité de l'utilisation des fichiers de dictionnaire, ce qui revêt une grande importance tant dans le craquage de mots de passe que dans d'autres scénarios d'application basés sur ce fichier de dictionnaire.