 Mistrz odzyskiwania haseł dokumentów
Jak filtrować duplikaty ze słownika 2T, Duży tekst filtrował duplikaty
W dziedzinie łamania haseł lub przetwarzania danych posiadanie pliku słownika typu tekstu 2T jest dość potężnym zasobem. Jednak tak duży plik często jest podatny na dużą ilość zduplikowanych danych, co nie tylko zajmuje niepotrzebne miejsce na pamięć, ale może także wpływać na wydajność późniejszych operacji opartych na tym pliku słownika, takich jak szybkość wyszukiwania haseł. Dlatego skuteczne filtrowanie duplikatów jest bardzo krytycznym krokiem.
1. Zrozumienie źródeł i skutków zduplikowanych danych
Najpierw musimy zrozumieć, dlaczego występuje tak wiele zduplikowanych danych. Podczas tworzenia pliku słownika dane mogą być gromadzone z wielu źródeł danych i istnieje częściowe nakładanie się między tymi źródłami danych. Na przykład podczas zbierania danych z różnych list słów, wspólnych zestawów haseł, różnych list kombinacji znaków itp. Niektóre podstawowe słowa lub proste kombinacje haseł mogą występować w wielu źródłach.
Te duplikaty danych mogą mieć wiele niekorzystnych skutków. Z punktu widzenia pamięci masowej przestrzeń 2T jest już bardzo duża. Jeśli jest w niej dużo duplikatów, jest to równoznaczne z marnowaniem cennej przestrzeni do przechowywania. Podczas faktycznego używania tego pliku słownika do łamania hasła lub innych operacji, duplikowana zawartość może powodować niepotrzebne operacje wyszukiwania i porównywania. Na przykład, jeśli podczas łamania hasła algorytm musi porównywać zawartość słownika z hasłem docelowym jeden po drugim, zduplikowana treść zwiększy liczbę porównań, spowolniając w ten sposób cały proces łamania.
2. Metoda filtrowania oparta na narzędziach do przetwarzania tekstu
Korzystaj z narzędzi w systemie Windows
-Korzystaj z PowerShell
-W systemie Windows PowerShell zapewnia bogate możliwości przetwarzania tekstu. Aby usunąć duplikaty wierszy, możemy użyć następującego skryptu PowerShell:
```powershell
$lines = get-content " dictionary.txt "
$uniqueLines = @ ()
foreach ($line in $lines) {
if ($uniquelines-notcontains $line) {
$uniqueLines + = $line
{
```
Ten skrypt najpierw odczytuje wszystkie wiersze w "dictionary.txt" do tablicy "$lines". Następnie przejdź przez każdy wiersz przez pętlę, a jeśli wiersza nie znajduje się w nowej tablicy „$uniqueLines”, dodaj go do nowej tablicy. Na koniec zapisz zawartość nowej tablicy w „unique_dictionary.txt”.
Algorytm podziału i pokonania
-Ponieważ nasz plik słownika jest bardzo duży (2T), bezpośrednie przetwarzanie może napotkać problemy takie jak niewystarczająca pamięć. Algorytm podziału i pokonania może bardzo dobrze rozwiązać ten problem. Możemy podzielić ten duży plik na kilka mniejszych podplików. Na przykład możemy podzielić go według określonej liczby wierszy lub rozmiaru pliku.
-Następnie powtórz filtrowanie każdego podpliku osobno. Ponowne połączenie przetworzonych podplików w jeden plik. Podczas procesu łączenia musisz również ponownie sprawdzić, czy nie ma duplikatów, ponieważ ta sama zawartość może występować między różnymi podplikami.
4. Zweryfikuj wyniki filtrowania
Po zakończeniu powtarzającego się filtrowania musimy sprawdzić, czy wyniki są prawidłowe. Możesz użyć kilku prostych metod, takich jak losowe wybieranie wierszy i sprawdzenie liczby występowań tych wierszy w pliku oryginalnym i filtrowanym. Jeśli pojawia się wiele razy w oryginalnym pliku i tylko raz w filtrowanym pliku, filtrowanie jest prawidłowe.
Alternatywnie można porównać rozmiar pliku oryginalnego i filtrowanego. Jeśli rozmiar filtrowanego pliku jest znacznie mniejszy niż plik oryginalny i działa normalnie w kolejnych testach (takich jak użycie tego pliku słownika do przeprowadzenia prostego testu wyszukiwania hasła w celu sprawdzenia, czy działa prawidłowo i nie brakuje hasła, które powinno istnieć), może to również oznaczać powtarzanie Prace filtrowe przyniosły dobre wyniki.
Nasz serwer wykorzystuje pamięć 512 G i szybki serwer z dyskiem twardym protokołu NVMe. Pomyślne przetwarzanie zajęło pół miesiąca i opracowano zestaw wydajnych skryptów przetwarzania. Jeśli masz jakieś potrzeby, możesz skontaktować się z obsługą klienta witryny, aby się porozumieć. Filtrowanie pułapek napotkanych podczas powtarzającego się procesu i pisanie automatycznych skryptów przetwarzania!
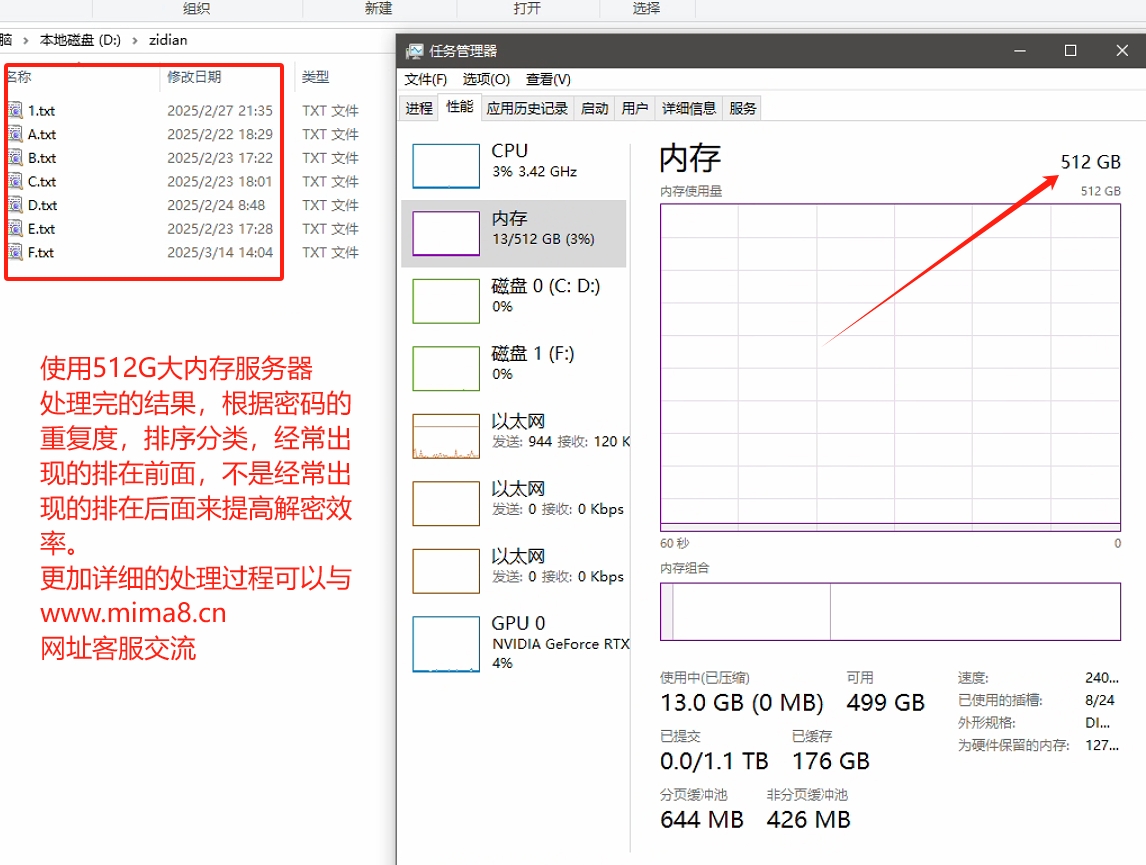
Filtrowanie duplikatów w plikach słownika typu tekstu 2T jest trudnym, ale bardzo koniecznym zadaniem. Rozsądnie wybierając narzędzia i algorytmy, możemy skutecznie usunąć zduplikowane treści oraz poprawić jakość i efektywność korzystania z plików słownika, co ma ogromne znaczenie zarówno w łamaniu haseł, jak i innych scenariuszach zastosowań opartych na tym pliku słownika.