 Κύριος ανάκτησης κωδικού πρόσβασης εγγράφου
Πώς να φιλτράρετε το διπλό περιεχόμενο από το λεξικό 2T, φιλτράρετε το διπλό περιεχόμενο με
Στον τομέα της διάσπασης κωδικών πρόσβασης ή της επεξεργασίας δεδομένων, η κατοχή ενός αρχείου λεξικού τύπου κειμένου 2T είναι ένας πολύ ισχυρός πόρος. Ωστόσο, ένα τόσο τεράστιο αρχείο είναι συχνά επιρρεπές σε μεγάλο όγκο διπλών δεδομένων, το οποίο όχι μόνο καταλαμβάνει περιττό χώρο αποθήκευσης, αλλά μπορεί επίσης να επηρεάσει την αποτελεσματικότητα των επακόλουθων λειτουργιών που βασίζονται σε αυτό το αρχείο λεξικού, όπως η ταχύτητα αναζήτησης κωδικού πρόσβασης. Επομένως, το αποτελεσματικό φιλτράρισμα του διπλότυπου περιεχομένου είναι ένα κρίσιμο βήμα.
1. Κατανόηση της πηγής και του αντίκτυπου των διπλών δεδομένων
Πρώτα απ 'όλα, πρέπει να καταλάβουμε γιατί παράγονται τόσα πολλά διπλά δεδομένα. Κατά τη διαδικασία κατασκευής ενός αρχείου λεξικού, είναι πιθανό να συλλέγονται δεδομένα από πολλαπλές πηγές δεδομένων και υπάρχει μερική επικάλυψη μεταξύ αυτών των πηγών δεδομένων. Για παράδειγμα, κατά τη συλλογή δεδομένων από διαφορετικές λίστες λέξεων, κοινά σύνολα κωδικών πρόσβασης, διάφορες λίστες συνδυασμών χαρακτήρων κ.λπ., ορισμένες βασικές λέξεις ή απλοί συνδυασμοί κωδικών πρόσβασης μπορεί να υπάρχουν σε πολλαπλές πηγές.
Αυτά τα διπλά δεδομένα θα έχουν πολλές δυσμενείς επιπτώσεις. Από την άποψη της αποθήκευσης, ο χώρος του 2T είναι ήδη πολύ μεγάλος Εάν υπάρχει πολύ διπλό περιεχόμενο, ισοδυναμεί με σπατάλη πολύτιμου αποθηκευτικού χώρου. Όταν χρησιμοποιείτε πραγματικά αυτό το αρχείο λεξικού για διάσπαση κωδικού πρόσβασης ή άλλες λειτουργίες, το διπλό περιεχόμενο μπορεί να οδηγήσει σε περιττές λειτουργίες αναζήτησης και σύγκρισης. Για παράδειγμα, εάν ο αλγόριθμος χρειάζεται να συγκρίνει το περιεχόμενο στο λεξικό με τον κωδικό πρόσβασης στόχο ένα προς ένα κατά τη διάρκεια της πυρόλυσης κωδικού πρόσβασης, το επαναλαμβανόμενο περιεχόμενο θα αυξήσει τον αριθμό των συγκρίσεων, επιβραδύνοντας έτσι ολόκληρη τη διαδικασία πυρόλυσης.
2. Μέθοδοι φιλτραρίσματος που βασίζονται σε εργαλεία επεξεργασίας κειμένου
Χρησιμοποιήστε εργαλεία κάτω από τα συστήματα Windows
- Χρησιμοποιήστε το PowerShell
- Στα συστήματα Windows, το PowerShell παρέχει πλούσιες δυνατότητες επεξεργασίας κειμένου. Μπορούμε να χρησιμοποιήσουμε το ακόλουθο σενάριο PowerShell για να αφαιρέσουμε διπλές γραμμές:
```powershell
$lines = Get - Content "dictionary.txt"
$uniqueLines = @()
foreach ($line in $lines) {
if ($uniqueLines - notcontains $line) {
```
Αυτό το σενάριο διαβάζει πρώτα όλες τις γραμμές στο "dictionary.txt" σε έναν πίνακα "$lines". Στη συνέχεια, κάθε σειρά διασχίζεται μέσω ενός βρόχου και εάν μια σειρά δεν βρίσκεται στον νέο πίνακα "$ uniqueLines", προστίθεται σε αυτόν τον νέο πίνακα. Τέλος, αποθηκεύστε το περιεχόμενο του νέου πίνακα στο "unique_dictionary.txt".
Αλγόριθμος διαίρεσης και κατάκτησης
- Δεδομένου ότι το αρχείο λεξικού μας είναι πολύ μεγάλο (2T), η άμεση επεξεργασία μπορεί να αντιμετωπίσει προβλήματα όπως ανεπαρκής μνήμη. Ο αλγόριθμος διαίρεσης και κατάκτησης μπορεί να λύσει πολύ καλά αυτό το Μπορούμε να χωρίσουμε αυτό το μεγάλο αρχείο σε πολλά μικρότερα υποαρχεία. Για παράδειγμα, μπορούμε να το χωρίσουμε σύμφωνα με έναν συγκεκριμένο αριθμό γραμμών ή μέγεθος αρχείου.
- Στη συνέχεια, εκτελείται επαναλαμβανόμενο φιλτράρισμα για κάθε υποαρχείο ξεχωριστά. Επανασυγχωνεύστε τα επεξεργασμένα υποαρχεία σε ένα αρχείο. Κατά τη διάρκεια της διαδικασίας συγχώνευσης, πρέπει επίσης να ελέγξετε ξανά εάν υπάρχει διπλό περιεχόμενο, επειδή το ίδιο περιεχόμενο μπορεί να υπάρχει μεταξύ διαφορετικών υποαρχείων.
4. Επαληθεύστε τα αποτελέσματα φιλτραρίσματος
Μετά την ολοκλήρωση του επαναλαμβανόμενου φιλτραρίσματος, πρέπει να επαληθεύσουμε εάν τα αποτελέσματα είναι σωστά. Μπορείτε να χρησιμοποιήσετε μερικές απλές μεθόδους, όπως η τυχαία επιλογή γραμμών και ο έλεγχος του αριθμού των εμφανίσεων αυτών των γραμμών στο αρχικό αρχείο και στο φιλτραρισμένο αρχείο. Εάν εμφανίζεται πολλές φορές στο αρχικό αρχείο και εμφανίζεται μόνο μία φορά στο φιλτραρισμένο αρχείο, το φιλτράρισμα είναι έγκυρο.
Επιπλέον, μπορείτε να συγκρίνετε το μέγεθος του αρχικού αρχείου και του φιλτραρισμένου αρχείου. Εάν το μέγεθος του φιλτραρισμένου αρχείου είναι σημαντικά μικρότερο από το αρχικό αρχείο και αποδίδει κανονικά σε επόμενες δοκιμές (όπως η χρήση αυτού του αρχείου λεξικού για μια απλή δοκιμή αναζήτησης κωδικού πρόσβασης για να δείτε εάν λειτουργεί σωστά και δεν λείπει ο κωδικός πρόσβασης που θα έπρεπε να υπάρχει), μπορεί επίσης να εξηγηθεί Η εργασία επανάληψης φιλτραρίσματος έχει επιτύχει καλά αποτελέσματα.
Ο διακομιστής μας χρησιμοποιεί μνήμη 512G, διακομιστή σκληρού δίσκου πρωτοκόλλου NVMe υψηλής ταχύτητας Επικοινωνήστε με την εξυπηρέτηση πελατών του ιστότοπου για επικοινωνία και φιλτράρισμα Οι παγίδες που αντιμετωπίστηκαν κατά τη διάρκεια της επαναλαμβανόμενης διαδικασίας και η σύνταξη σεναρίων αυτόματης επεξεργασίας!
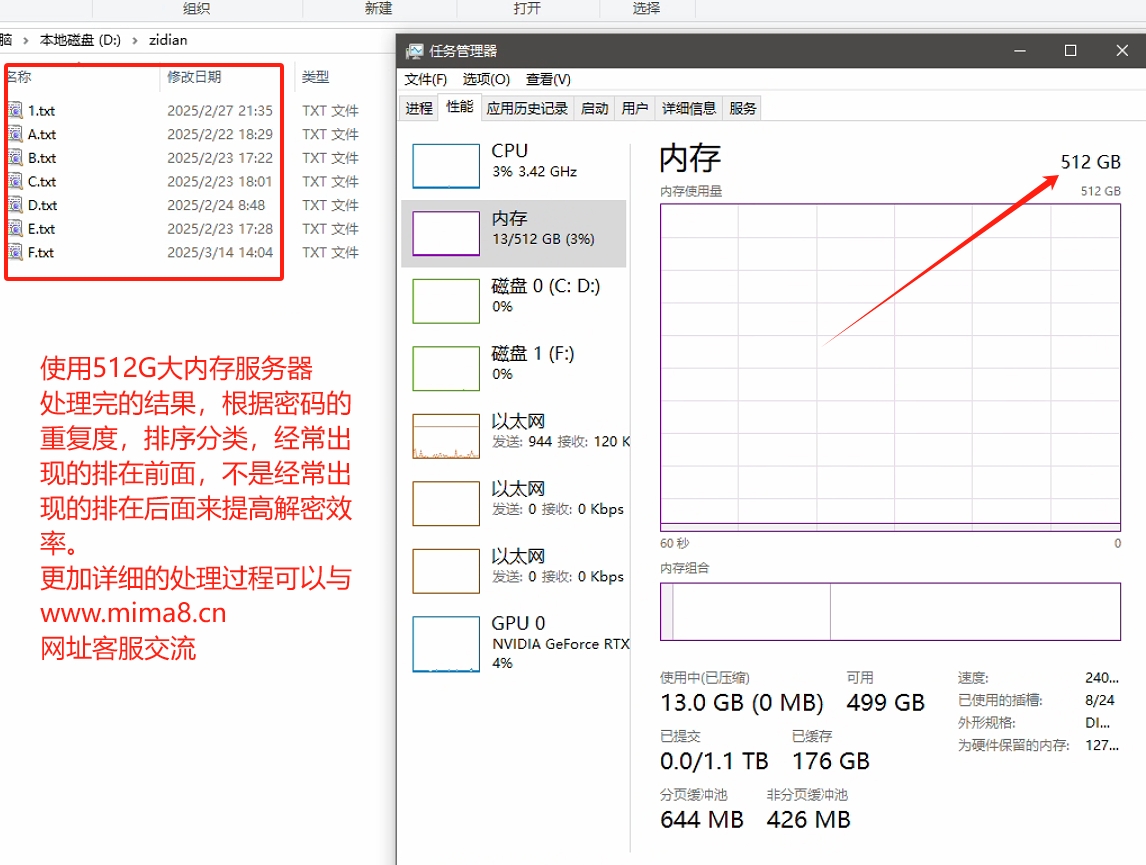
Το φιλτράρισμα του αρχείου λεξικού τύπου κειμένου 2T για διπλότυπο περιεχόμενο είναι μια δύσκολη αλλά πολύ απαραίτητη εργασία. Με την εύλογη επιλογή εργαλείων και αλγορίθμων, μπορούμε να αφαιρέσουμε αποτελεσματικά το διπλό περιεχόμενο και να βελτιώσουμε την ποιότητα και την αποτελεσματικότητα των αρχείων λεξικού, κάτι που έχει μεγάλη σημασία τόσο στη διάσπαση κωδικού πρόσβασης όσο και σε άλλα σενάρια εφαρμογών που βασίζονται σε αυτό το αρχείο λεξικού.